卧槽,Gemini 3 pro在网页端已推出!!


更多动态
Google Antigravity 把 IDE 变成了“智能体指挥中心”,你不再是码农,而是指挥 Gemini 3 多线程干活的技术总监。 🔹 原理秒懂:以前 Copilot 是你的“副驾”,现在 Antigravity 直接给你配了一个完整的“敏捷开发小组”。 1️⃣ 并行协作(Agent-first) 你在 Mission Control 下达需求,后台自动拆解任务:Agent A 写后端逻辑,Agent B 跑单元测试,Agent C 处理前端交互。多线程并行,速度比单人手撸快几个量级。 2️⃣ 所见即所得的工件(Artifacts) 它解决了 AI 编程最大的痛点——信任。它不只吐代码,还输出“工件”:实施计划、UI 截图、甚至运行录屏。哪里不对?直接在图上圈出来(Grounding),Agent 自动微调,无需重新写 Prompt。 3️⃣ 全自动闭环验证 集成了 Chrome 扩展,Agent 能调用 Computer Use 模型模拟真实用户在浏览器里点击、输入、测试,自己发现 Bug 自己修。 💡 开发者建议: 底层基于 VS Code(插件生态无缝迁移),目前 Mac/Win/Linux 全平台免费开放。对于复杂项目重构,建议利用其长上下文优势进行端到端测试,这是目前比 Cursor 更激进的尝试。 🔗 官网下载: antigravity.google 📄 技术文档: deepmind.google/gemini-3 #AI工作流 #GoogleAntigravity #全栈开发 #Gemini3 #生产力工具

微博开源 VibeThinker-1.5B,用“频谱到信号”新范式证明:逻辑推理能力不靠堆参数,而靠精细化的训练策略。 原理其实像“特种兵特训”:先通过多位专家模型蒸馏,让模型见识各种解题思路(Spectrum);再用 MGPO 算法奖励那些“极少数但正确”的路径(Signal),专攻数理逻辑,而非死记硬背。 🔹 以小博大:在 AIME 24/25 数学测试中,1.5B 参数的分数(80.3/74.4)超过了 671B 的 DeepSeek R1,证明小模型足以胜任复杂推理。 🔹 成本极低:后训练全流程仅耗资 $7,800(约 5.6 万人民币),相比大模型动辄几十万刀的投入,把微调门槛降到了个人开发者可接受的范围。 🔹 部署友好:支持 PyTorch 和 GGUF,单张消费级显卡(如 RTX 4090)甚至端侧设备即可本地流畅部署,延迟降低 42%。 👨💻 配置建议:推理时推荐 Temperature 设为 0.6 或 1.0,Top-p 0.95,Max Context 设为 40,960 token 以确保长思维链(CoT)完整输出。 🔗 模型下载:huggingface.co/WeiboAI/VibeThinker-1.5B #AI工作流 #本地部署 #边缘计算 #VibeThinker

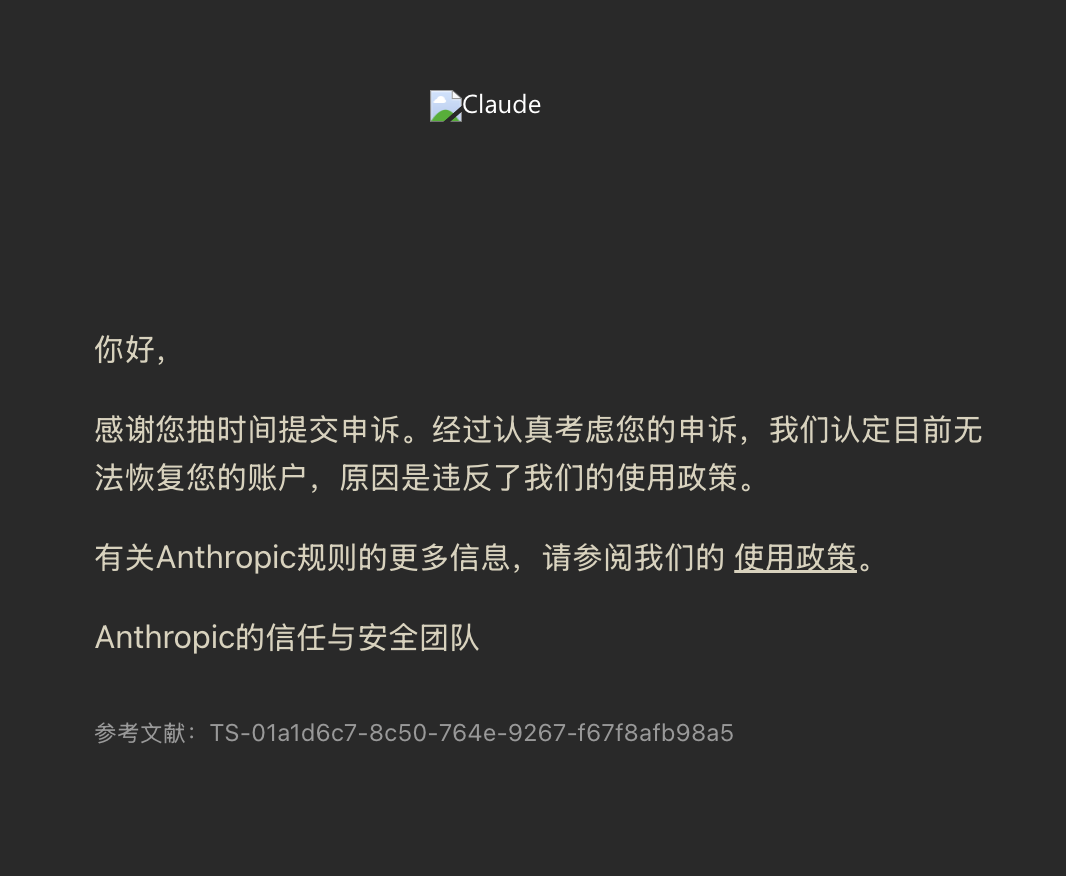
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。
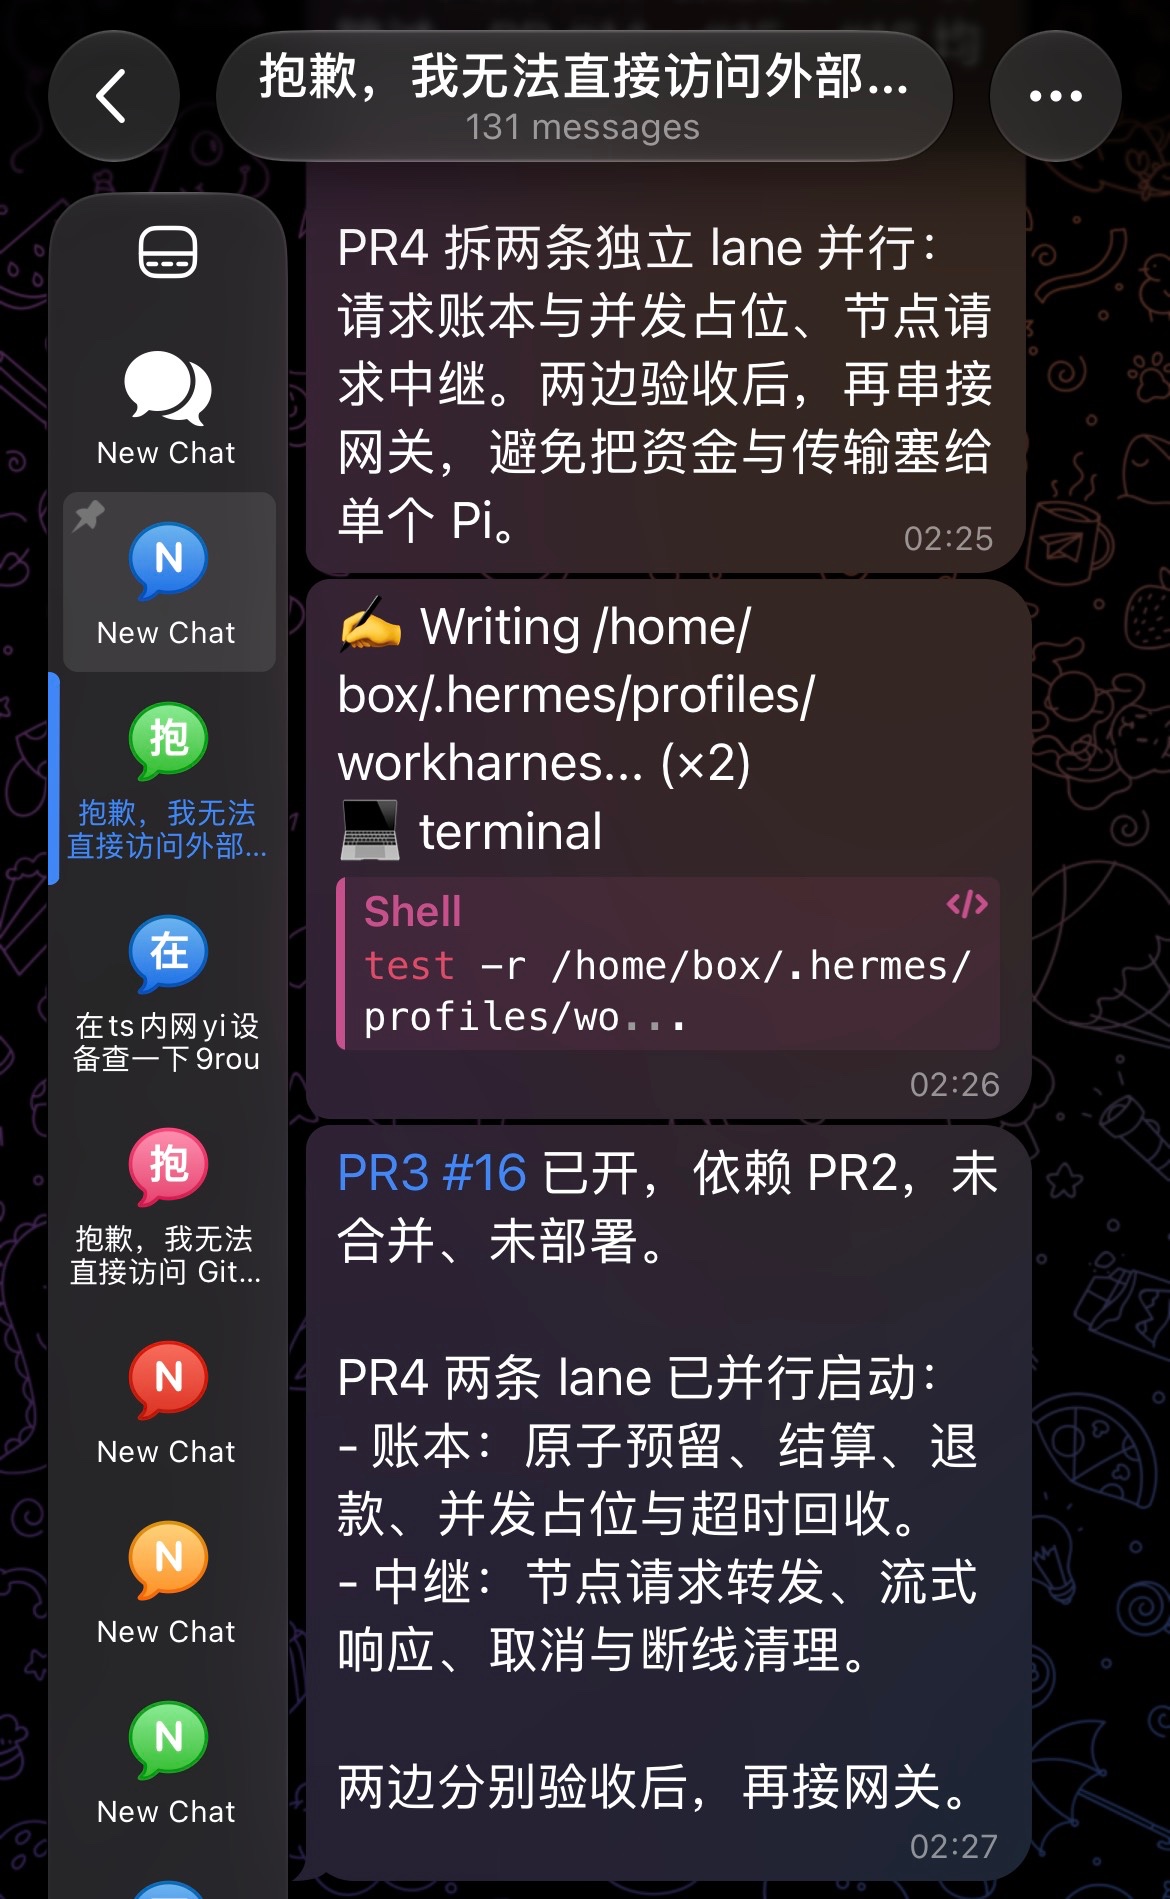
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。