视频创作流彻底变天,还在用旧工具“抽卡”会直接拉低产出效率

更多动态
首个全栈开源 GUI Agent,把移动端自动化的门槛打下来了
以前搞手机自动化要自己写 ADB 驱动、配环境,现在 GELab-Zero 直接开源了“模型+基建”整套流水线。 原理类似给手机装了个“AI 驾驶员”,但这回连车(基础设施)和路(环境配置)都给你铺好了,主打一个快速落地。 🔹 开箱即用的基建:不仅开源了 4B 模型,更解决了最耗时的多设备连接、ADB 权限管理和任务编排,支持 Python 3.12+ 一键部署。 🔹 小参数高性能:基于 Qwen2-VL 调优,4B 规模在消费级显卡就能流畅运行,配合 Ollama 或 vLLM,实测在 AndroidWorld 复杂任务成功率达 75.86%。 🔹 真实场景优先:相比通用大模型,它专门针对打车、外卖等高频生活 App 做了特训,数据完全本地处理(Local Inference),隐私零泄露。 🔗 GitHub:github.com/stepfun-ai/gelab-zero 自动背单词演示 👆

Lovart 新出的 Touch Edit 把“P 图”
变成了“指点江山”,实测能将 90 分钟的枯燥修图压缩至 7 分钟,真正实现了从工具人到创意主导的转变。 1️⃣ 指哪改哪 (Mark & Edit) 抛弃复杂的蒙版与套索。按住 Cmd / Ctrl + 点击画面任意元素(如发丝、衣服),AI 瞬间锁定区域。直接输入自然语言(如“换复古旗袍”),系统自动计算透视与光影,完成像素级融合。 2️⃣ 多图重组 (Select & Remix) 素材不再是孤岛。你可以抓取 A 图的构图、B 图的材质、C 图的光效,像“拼乐高”一样拖拽组合。这解决了传统 AI 生图“抽卡”随机性过强、无法精确控制的痛点。 3️⃣ 交付即工程 (Layer Separation) 这是区别于玩具的关键:它不只吐出 JPG,而是生成可拆分的“类 PSD 工程文件”。文字、主体、背景自动分层,支持二次精修,直接打通了从创意到商用交付的最后一公里。 目前公测阶段无需付费,正式版预计明年 1 月上线,建议设计师和运营尽早跑通这个工作流。 🔗 官网:https://www.lovart.ai #AI工作流 #设计提效 #Lovart #生产力工具 #数字游民

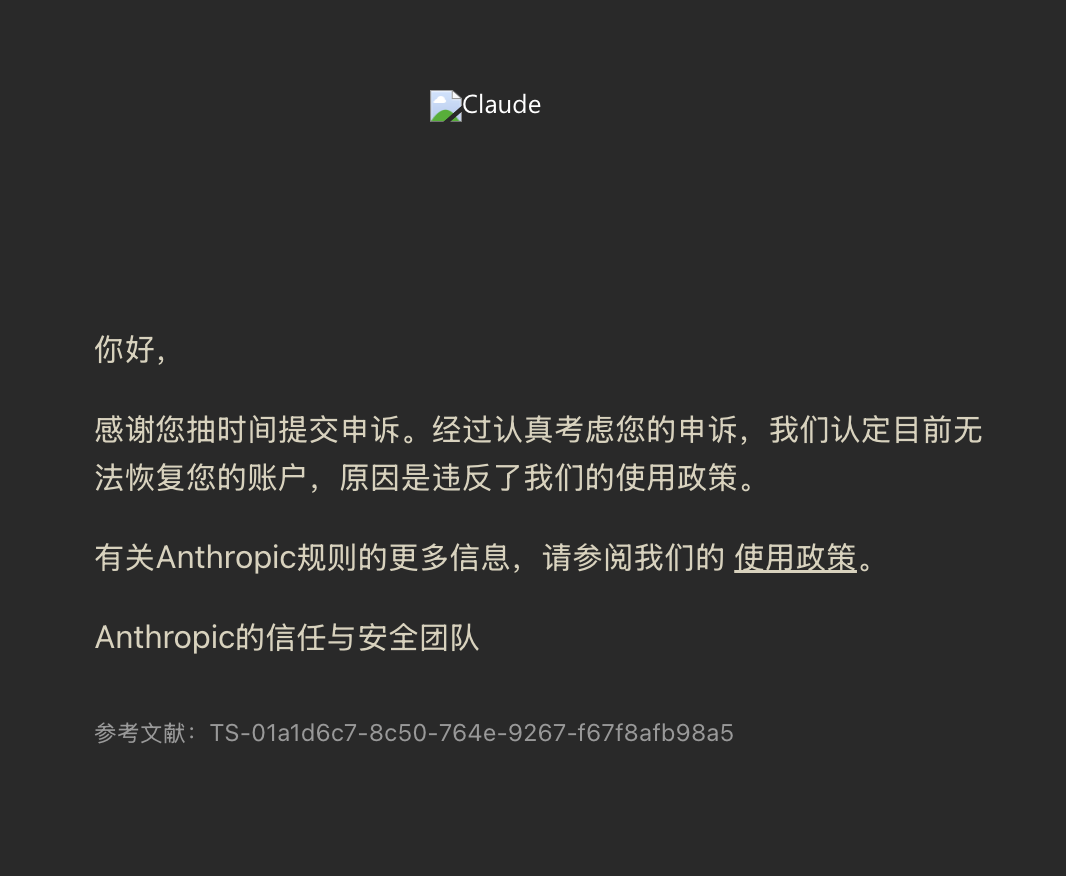
claude申诉失败了。
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。

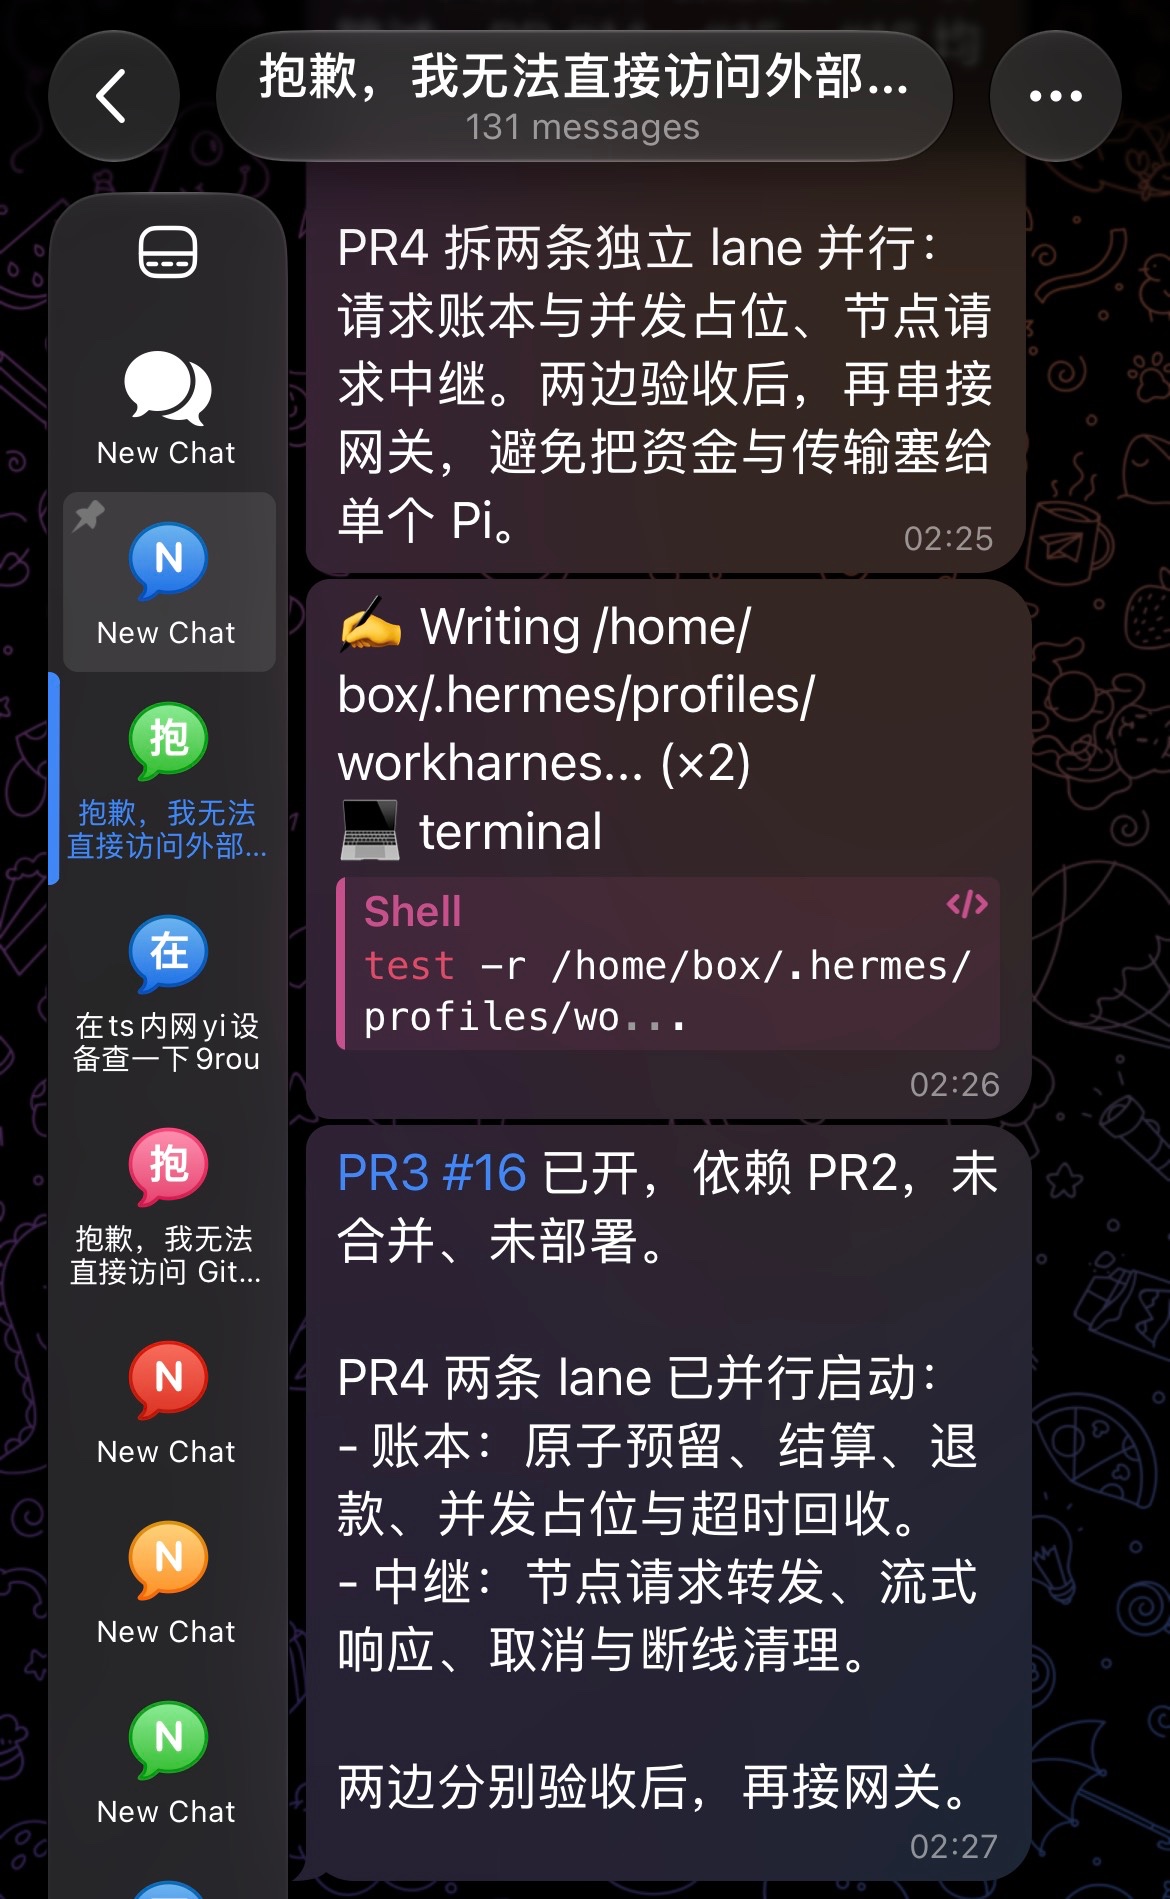
分享下现在的纯手机端工作流。
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。