为啥在Gemini App用Gems会丢聊天记录?
为啥在Gemini App用Gems会丢聊天记录?
更多动态
⚠️ Antigravity 更新速率限制:付费版改 5 小时刷新
,免费版变周配额。 1️⃣ 付费用户(Pro/Ultra): 拿到最高优待。重点是配额机制改为「每 5 小时刷新」,这意味着高强度 Coding 时能快速回血,不用死等第二天,非常适合冲刺型开发。 2️⃣ 免费用户: 策略调整为「周度大额度」。这其实更符合现实——遇到复杂任务可以集中消耗一周的量突击解决,避免因单日限额过低导致思路卡壳。 3️⃣ 通用权益: 无论是否付费,Gemini 3 Pro、无限代码补全 (Infinite tab) 和 Agent Manager 依然全员开放,这点没缩水。 #AI开发 #Gemini #降本增效 #独立开发

本地跑通“类 GPT-4o”实时语音交互的最后门槛被踏平了
微软本周开源 VibeVoice-Realtime-0.5B,用极低算力实现 <300ms 延迟的流式 TTS,且支持 MIT 协议免费商用。 1️⃣ 消费级硬件门槛 仅 0.5B 参数,推理显存占用不到 2GB VRAM。这意味着你不需要 A100,用家用 RTX 3060 甚至高性能 CPU 就能跑。对于想做本地 AI 助理或硬件产品的开发者,这直接把端侧成本打下来了。 2️⃣ 核心原理简化 为什么它能做到 <300ms 响应?关键在于 7.5Hz Acoustic Tokenizer。这就好比把原本庞大的音频数据压缩了 3200 倍,再喂给底层的 Qwen2.5 模型。这种“极高压缩率 + Streaming 流式输出”,让 AI 能像真人一样“边想边说”,彻底消除了传统 TTS 的转圈等待感。 3️⃣ 避坑与现状 虽支持 90 分钟长文不崩溃,但 0.5B 版本目前专攻“单说话人”效率,且中文多音字处理偶尔不如 F5-TTS 细腻。如果是做多角色对话,建议等更大的 1.5B 版本。 🔗 模型地址: https://huggingface.co/microsoft/VibeVoice-Realtime-0.5B #AI工作流 #本地部署 #VibeVoice #开源 #开发效率
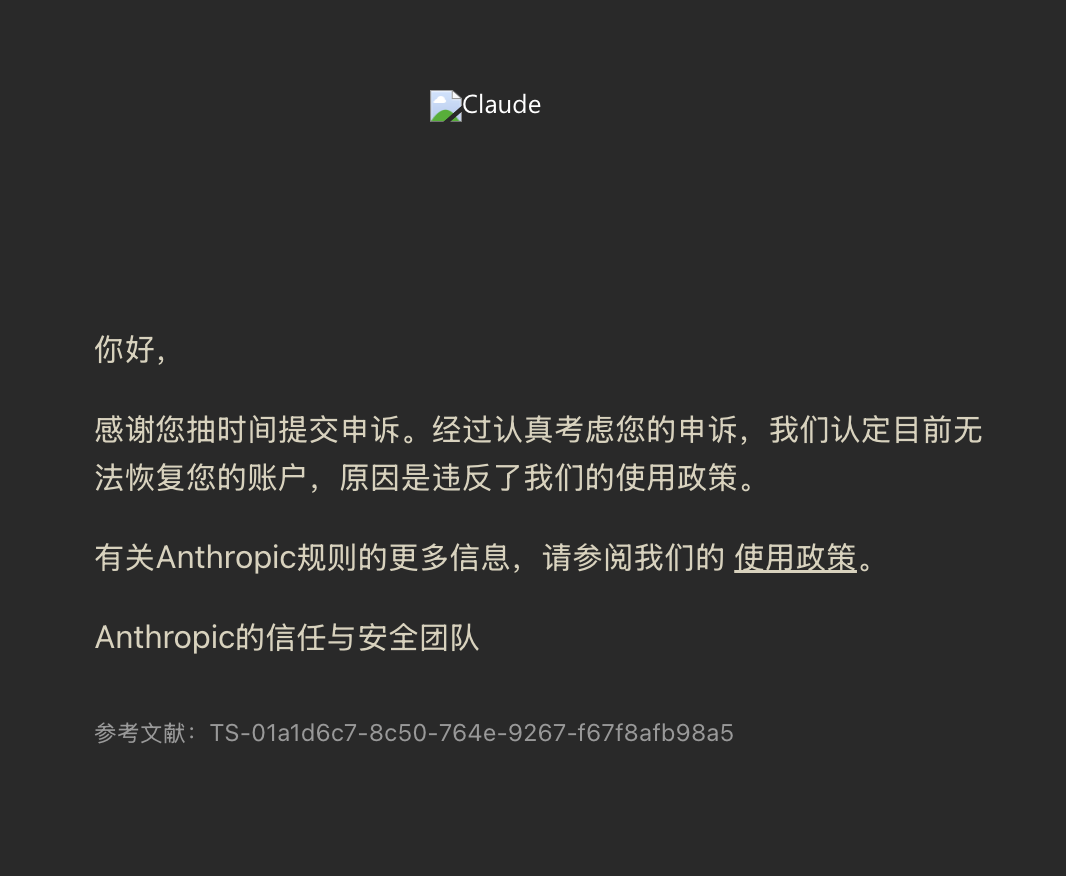
claude申诉失败了。
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。
分享下现在的纯手机端工作流。
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。