想做 24/7 无人直播却卡在“一眼假”?
阿里发布 Live Avatar:基于 14B 参数扩散模型的无限时长、实时数字人方案,解决长时序生成“脸崩”痛点。
RAG 是给大模型挂外脑,Live Avatar 则是给视频生成装了“流水线”和“校准器”。
🔹 无限时长不崩坏:传统模型生成久了容易身份漂移(变脸),它引入 RSFM(滚动锚定帧)机制,每生成一步都回头校准初始特征,实测 10,000 秒直播唇形与面部依然稳定。
🔹 实时性突破:利用 TPP(时间步流水线并行)将复杂的去噪过程拆解到多张 GPU 像流水线一样并行处理。在 5 张 H800 上实现 20 FPS,硬是将非实时的 Diffusion 变成了实时流。
🔹 落地即变现:无需繁琐训练,一张图 + 音频即可驱动。结合 LLM 做智能客服或带货主播,官方数据显示转化率提升 25%,大幅降低人工成本。
🔗 项目主页:https://liveavatar.github.io
#AI视频 #虚拟人 #电商直播 #LiveAvatar
想做 24/7 无人直播却卡在“一眼假”?
更多动态
以后做方案别再死磕 PPT了。
Google Mixboard 迎来重大更新:基于 Nano Banana Pro 模型,将“灵感碎片”转化为“专业 PPT”的路径被压缩到了 10 分钟。 原理类似一个“自带设计师的无限白板”:你只管丢进去想法(Prompt)和素材,它负责生成视觉、组织逻辑并自动排版。 几个实测体验: 1️⃣ 工作流重构:告别传统「找素材-手动对齐」,现在是 Canvas 拖拽布局 -> AI 补全上下文 -> One-click 导出 PPTX,效率提升肉眼可见。 2️⃣ 审美在线:新模型生成的图像并非简单的拼凑,支持涂鸦修改(Sketch-to-Image)和风格统一,解决了 AI 生成图“一眼假”和素材违和的通病。 3️⃣ 使用门槛:目前需美区环境 + 18岁验证。建议优先用于前期提案、Moodboard 或品牌展示,复杂数据图表仍需人工后期干预。 👉 官网:labs.google.com/mixboard #AI工作流 #PPT制作 #GoogleLabs #效率工具
苹果刚开源 STARFlow-V,用“归一化流”重构视频生成
,速度快且长视频更稳。 技术原理简化: 主流 Diffusion 像“雕刻”,需几十步循环去噪才能出画面;STARFlow-V 的 Normalizing Flows 技术更像建立了一条“直达通道”,通过数学变换直接将噪音映射为视频,无需反复迭代。 核心亮点: 🔹 效率暴增:70亿参数 (7B) 模型,因非迭代特性,生成 5 秒视频的速度比初始版本快 15 倍,且训练只需单次前向传播。 🔹 长视频更稳:在 30 秒长视频测试中,画面一致性表现优于各类 Diffusion 竞品,有效缓解了“时间越长画面越崩”的通病。 🔹 原生多模态:得益于可逆架构,无需针对 T2V、I2V 或视频编辑分别修改模型,一套架构直接通吃。 ⚠️ 硬件短板:目前输出仅 480p @ 16fps,物理规律模拟(如物体碰撞)仍有缺陷,离商业级商用还有距离。 项目与代码:https://github.com/apple/ml-starflow #AI视频 #开源模型 #深度学习 #AppleSilicon #技术趋势
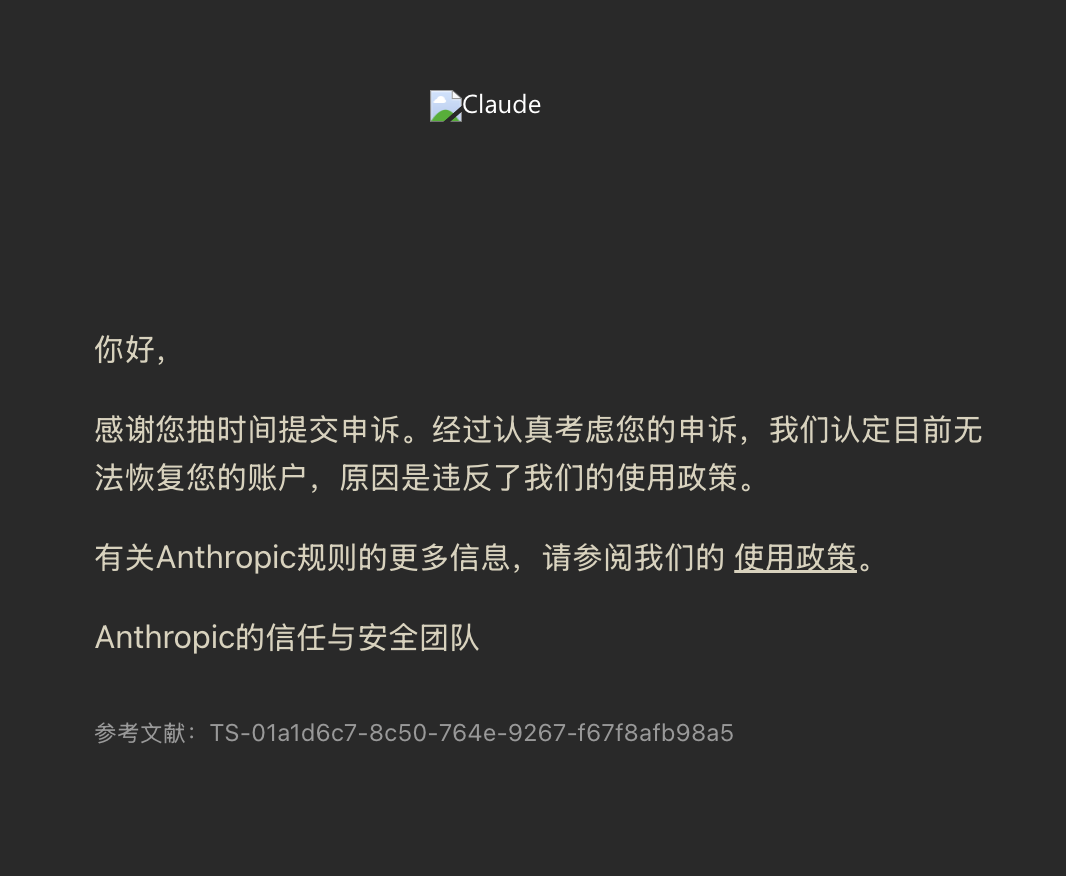
claude申诉失败了。
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。
分享下现在的纯手机端工作流。
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。