🎙 刚看到通义实验室开源了这个端到端 (S2S) Fun-Audio-Chat 8B 模型,这不仅仅是陪聊工具,更像个长了耳朵的 Agent。
1️⃣ 动口不动手:最戳我的是 Voice Function Calling。以前我在开车时想处理个急事,只能干着急,现在直接吼一声让它调工具查资料、做翻译。
2️⃣ 情绪感知很敏锐:尝试用崩溃的语气跟它吐槽了两句,它居然能听出我的疲惫语气并给反馈,比那种只会在云端念稿子的 AI 像人多了。
3️⃣ 配置门槛友好:双分辨率架构确实省显存(官方说降了 50%),实测在我这台非顶配机器上跑,延迟完全在可接受范围内。
预测这个模型特别适合想做语音交互 App 的朋友。
#AI工作流 #FunAudioChat #开源模型 #独立开发 #语音交互
🎙 刚看到通义实验室开源了这个端到端 (S2S)
更多动态
PixVerse 新出的这个“全视频编辑”,把 AI 视频从“盲盒抽卡”
变成了可控的“后期精修”。 它现在的逻辑是“元素级编辑”,你可以像修图一样修视频: 1️⃣ 救命场景:上周我剪片子,客户临时反馈说产品展示的“光影太硬”。以前这种得重拍或者回达芬奇扣半天,这次我试着用 PixVerse 框选主体 + Prompt 调整光线,大概十分钟就发回去了。 2️⃣ 素材复用:如果你是做 MCN ,手里那点素材不够用,可以直接改拍摄角度或场景。实测把一段普通街景改成赛博朋克风,主体稳定性比直接重绘要高不少。 虽然比之前的全屏重绘准,但复杂动态下的人物边缘偶尔还是会“飘”,建议先拿非人像素材练手。 对于咱们这种单兵作战的创作者,能用 AI 解决的返工,就别浪费体力了。 #AI工作流 #PixVerse #视频制作 #独立开发者 #效率工具
Qwen 刚发布的这俩新模型
,可能要省掉我每个月给 ElevenLabs 交的订阅费了。 主打「3 秒克隆」和「文本捏人声」,对于我们这种要做多语言视频的创作者来说,吸引力很大。 具体有两个新成员: 1️⃣ VoiceDesign (VD-Flash):不用找现成音色,直接用 Prompt「捏」声音。 假如我想给独立开发的小游戏 NPC 配个“焦虑的中年侦探”音色,以前得在素材库翻半天,现在写几行指令就能生成。官方测试说在角色扮演场景下比 Gemini-2.5-pro 还稳。 2️⃣ VoiceClone (VC-Flash):只需 3 秒干音就能克隆。 这对出海做内容太友好了,支持中英日等 10 种语言。我试着把我的中文克隆成西班牙语,语调的上下文断句比 Grok 要自然,没有那种明显的“机械感”。 虽然官方数据说错误率低了 15%,但我实测感觉在极快语速下还是偶尔会吞字,不过作为生产力工具完全够用了。 #AI语音 #独立开发 #Qwen #开源模型 #效率工具
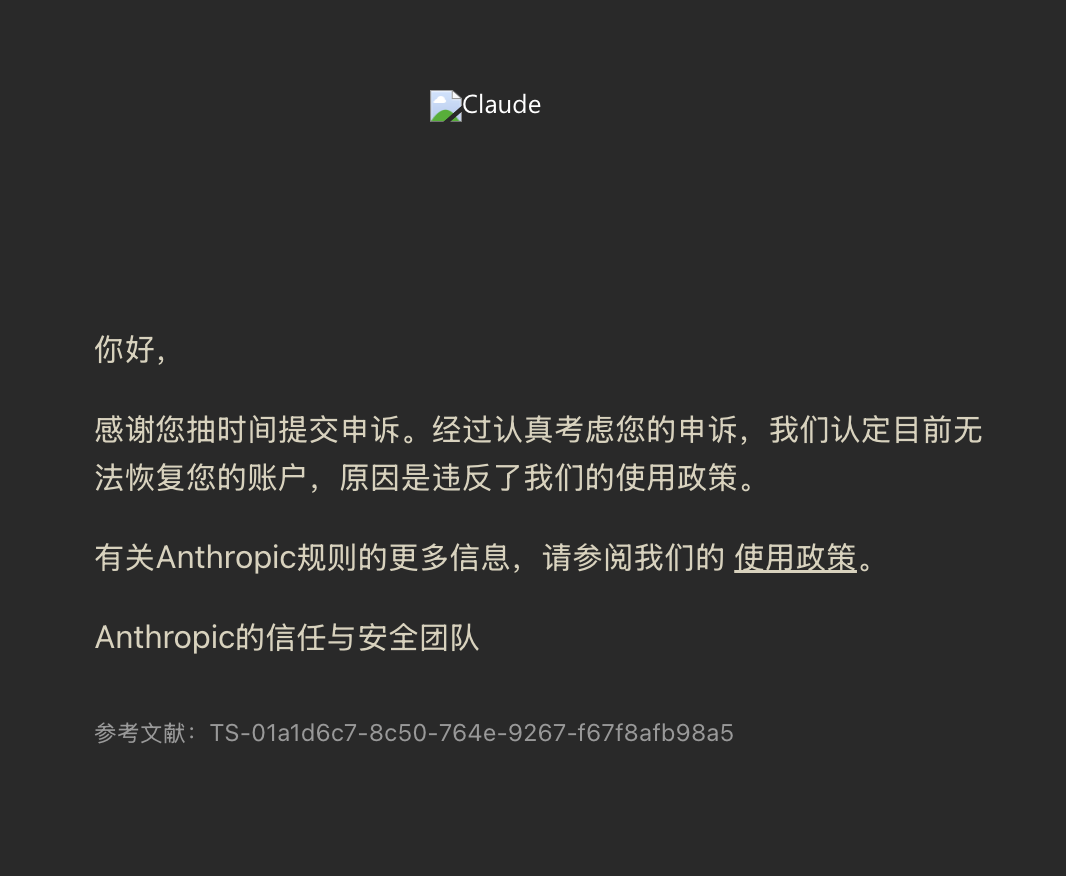
claude申诉失败了。
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。
分享下现在的纯手机端工作流。
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。