被OpenAI GPT Image 2.0新版本惊艳到了,文本渲染几乎完美,生成的手绘航海日志字迹清晰,真实


更多动态
,把图片拆成可编辑的图层,并保持原生字体。 以前我经常在lovart用edit elements,它也是拆解图层的功能,但会丢字体导致排版错乱,拆完后还需要自己挨个调整排版,很麻烦。 canva的magic layers效果就好多了,AI 自动识别图片中的文字、前景对象和背景,拆成独立图层。文字字体不变,能直接编辑文本框,元素随便移动替换,排版不会乱。 目前还在 Beta,Pro 用户每月 500 次,免费用户额度少点。

我之前让 Agent 读个网页,得折腾爬虫,或者花钱买 API 额度,还很容易封IP。 这个Dokobot 的思路很直接,让 AI 直接连你本地的 Chrome。一行命令,你浏览器里能看到的内容,Agent 就能读。 Agent 读页面用的是你当前的浏览器环境。这意味着你的 Gmail、Twitter、各种账号后台、甚至付费墙内容,Agent 都能直接读。不需要倒腾 Cookie,不需要重新登录。 本地模式完全免费,没有额度限制。对比 Firecrawl 或者 Browserbase 这种按量计费的云端爬虫服务,简直降维打击。 例如在TG上跟 openclaw 说:“帮我看下邮箱里客户刚发的报价单。”。 Dokobot 会直接调取你已登录的 Gmail,提取内容转成 Markdown 喂给 openclaw。全程不用配 API,也不用操心反爬机制。 🔗 dokobot.ai

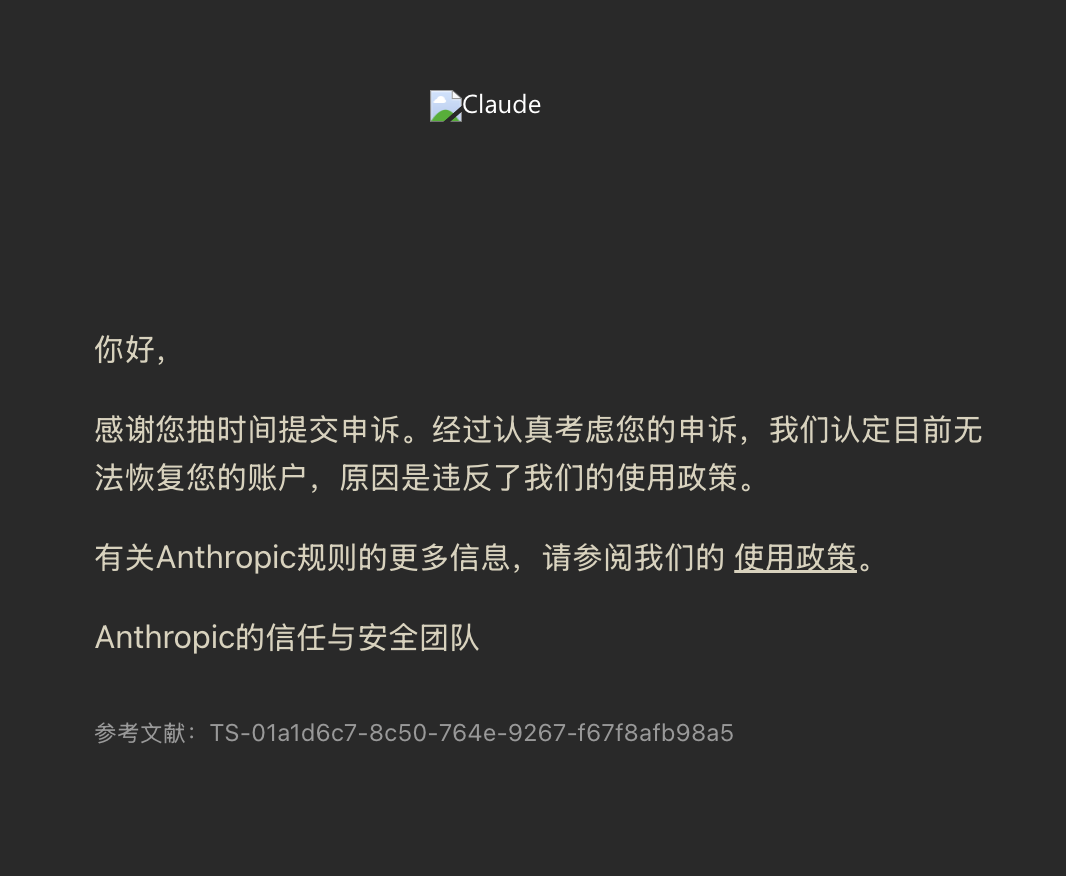
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。
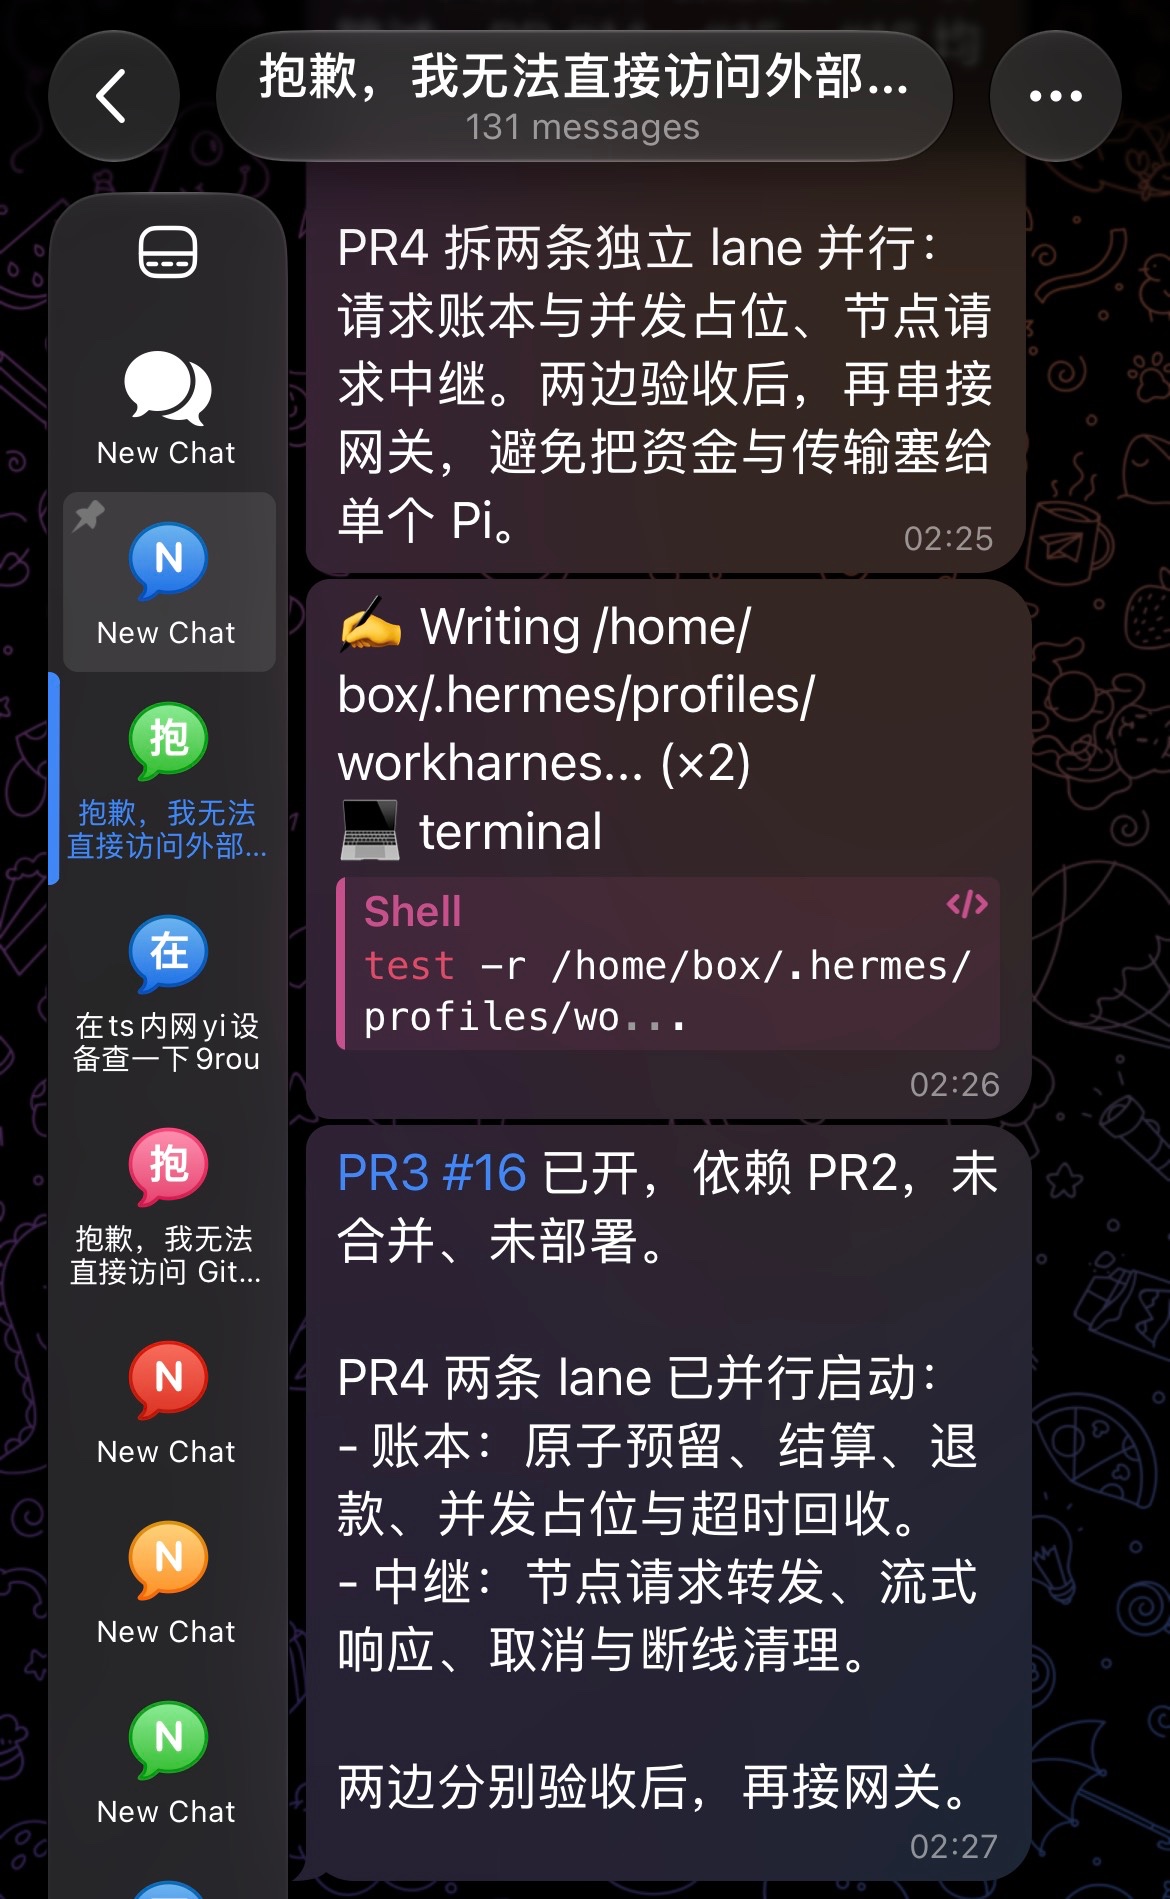
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。