更多动态
小米开源的 MiMo Code v0.1.0,基于opencode。 记忆系统是亮点,思路是让主agent专心干活,记忆完全外包给独立subagent。 窗口快满了subagent自动压缩成干净的总结,主agent接着干。 还有个 /dream 命令,每7天自动触发,用的越久,它越懂你的项目。 - 合并历史会话 - 去重冗余 - 压缩成紧凑状态快照 SWE-Bench Pro上,同样MiMo-V2.5模型,MiMo Code 62% ,Claude Code 57%。 MIT协议开源,内置MiMo-V2.5限时免费,无需注册。

最近我在忙着用pi搭建一个项目内多agent并行工作的系统,也就是Factory Model。 实现逻辑很简单,用worktree给每个agent创建单独的空间,主窗口agent编排,用plan subagent将单个目标拆分成多个task,每个task又划分成并行或串行的wave,每个wave单独一个worktree。 紧接着依次执行wave,并行的wave同时派遣多个subagent完成task,串行的wave派遣单个subagent依次完成task。最后统一merge和处理冲突。 难点在于在这套复杂的系统中,主窗口的上下文工程很难优化,经常token爆炸。为了控制主窗口的token消耗,这几天对这套系统进行了反复重构。

订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。

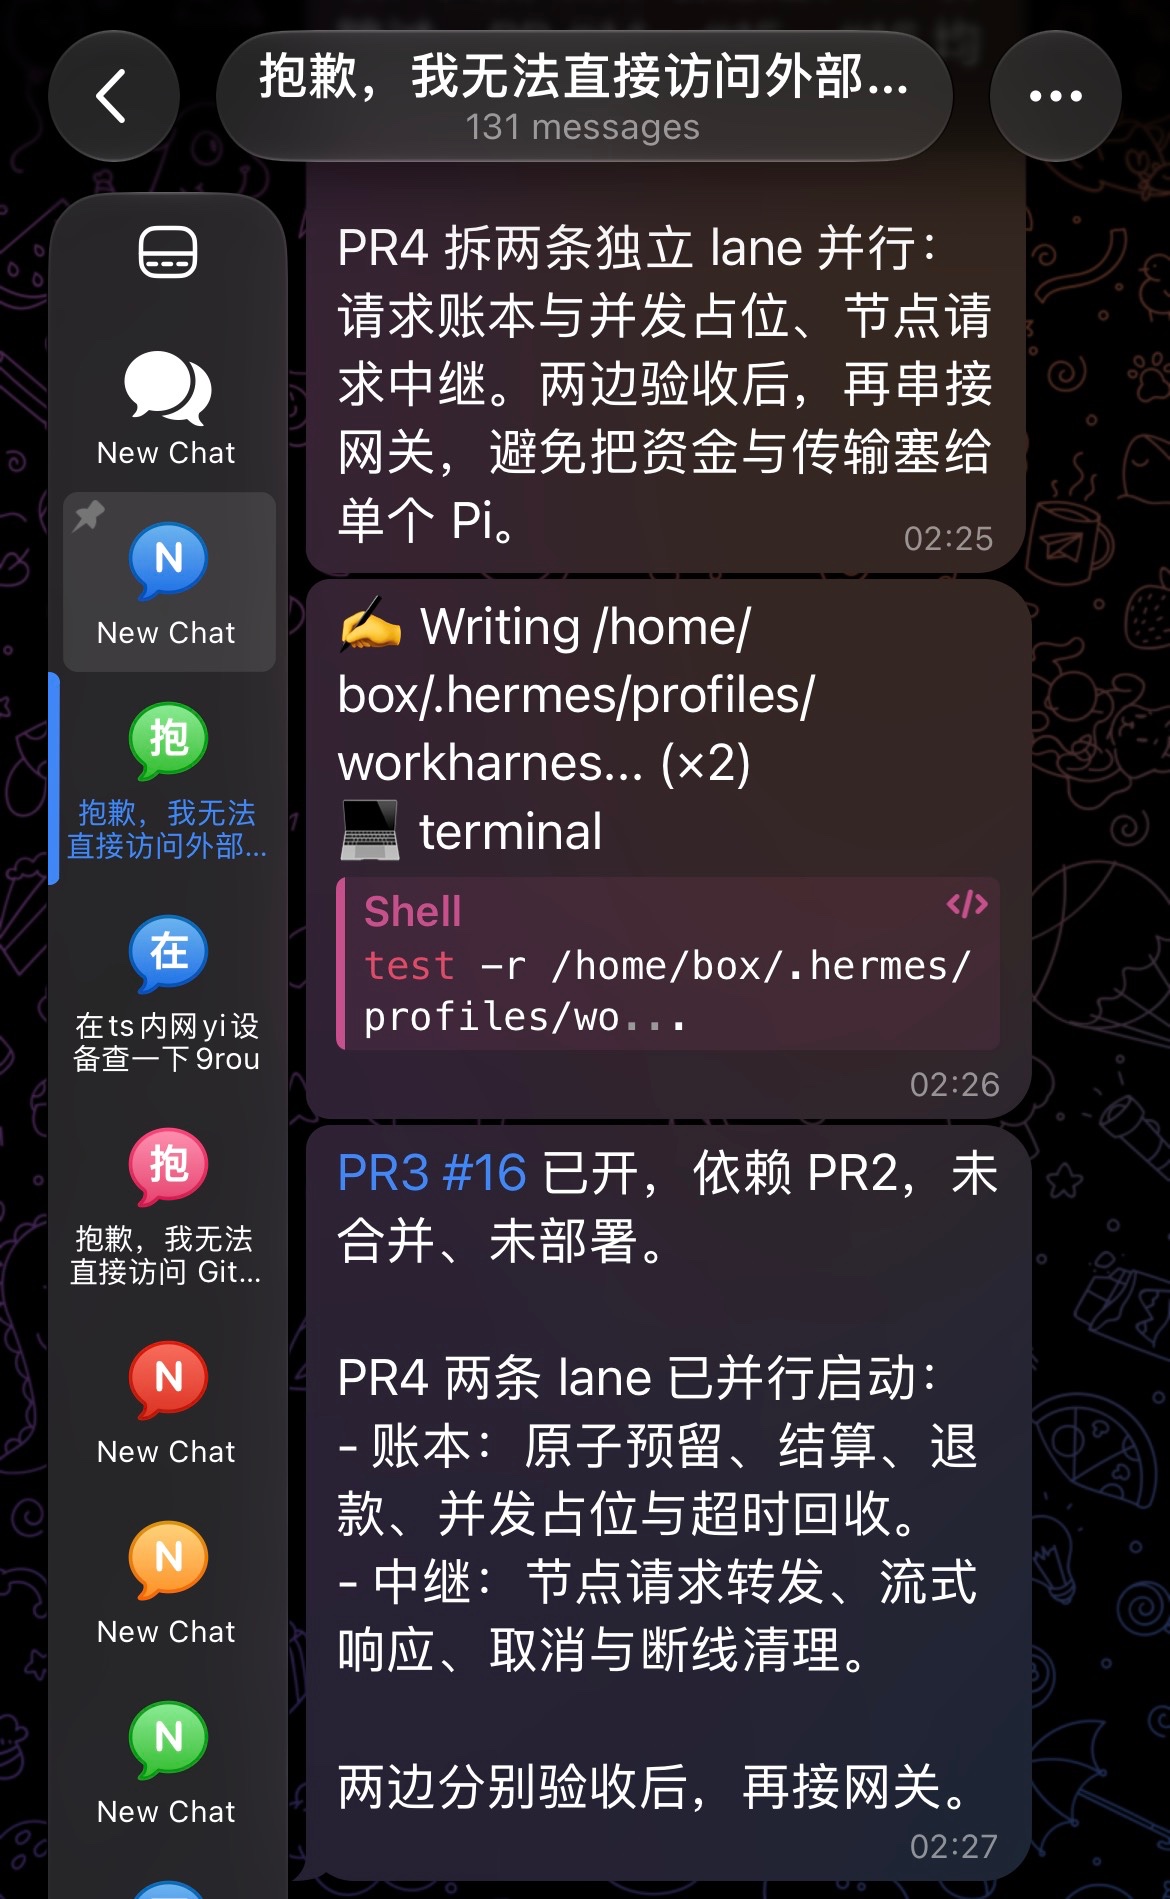
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。