deepseek harness 手机智能体最佳方案

更多动态
免费云端 agent ,送服务器
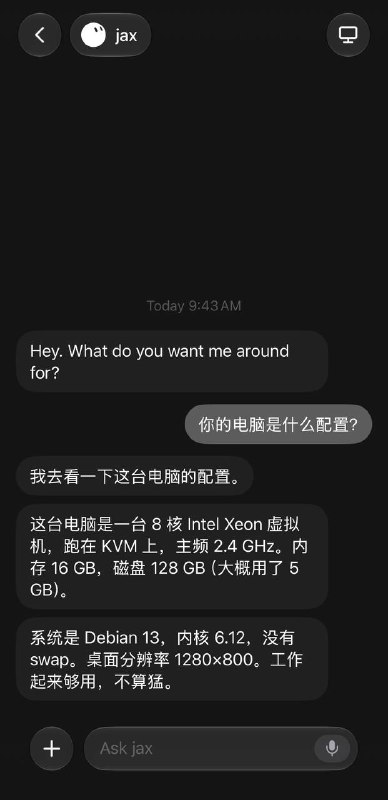
昨天 grok bot 下放到了 supergrok plus ,今天一看又下放到了 supergrok 。 等于买 supergrok 送 grok bot + 云端服务器。 问了下 grok bot 服务器的配置,相比 heavy 的 128G 内存,只有 16 G 。 bot 额度貌似与 build 不共享,因为我的 build 已经周上限了, 但 bot 还能聊天。

DeepSeek 涨价 12 倍(+1100%)后,普通人怎么用模型?
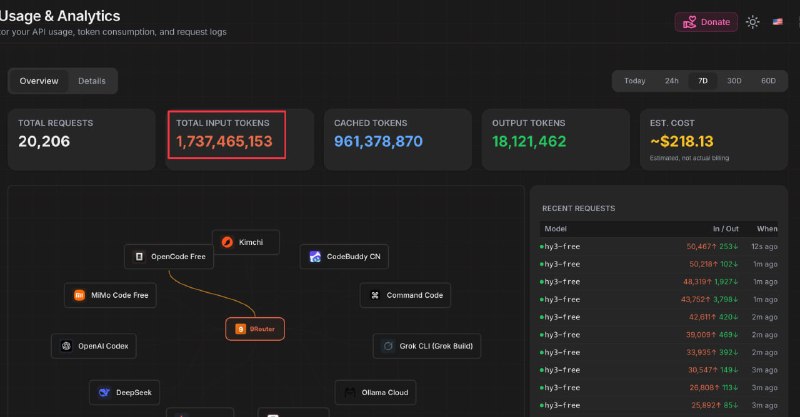
自从 8 月 16 日涨价后,这一周花了我一千多,而且 ds 主要还是兜底模型(fallback)。当然我的 token 消耗也多,所有模型加一起每周要 1B 多。 我主要面向 coding 场景,其他场景也可以参考。首先要专模专岗,不要所有场景都用一个模型,例如网络搜索(research)、本地搜索(explore)我就用免费的模型或者便宜的模型,只有计划、决策大方向、难点的任务我才会用第一梯队的模型。 所以现在至少需要两个模型,一个第一梯队的模型,例如 ChatGPT 和 Grok 的订阅。一个便宜或免费的模型,例如 Hy3 干杂活够用了。 目前我自己的方案是ChatGPT 和 Grok 双订阅用顶级模型 + commandcode 一美元订阅灵活调用顶级模型或便宜模型,最后再外加 50 个 IP 池轮询 opencode hy3-free 模型(每个 IP 每天有免费的额度,无需登录),以及 workbuddy 每天签到领积分低积分消耗调用 hy3 。

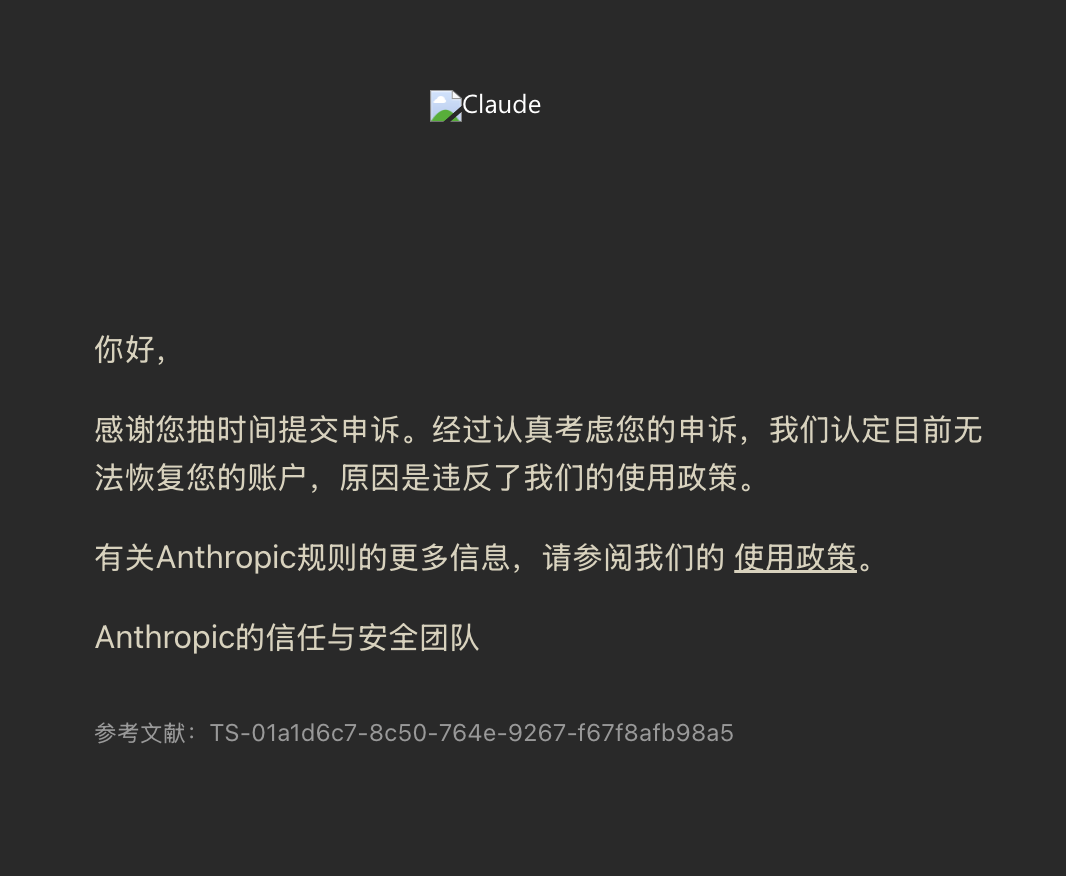
claude申诉失败了。
订阅费也没法儿退,我甚至怀疑申诉邮件就是钓鱼的,有追踪IP地址。 dhh是美国开发者,前段时间来深圳交流,演示了自己怎么用claude code。 目前最稳妥的方式就是参考dhh方法,把Claude code放在海外机器上,用tailscale远程连接使用。 那就得租一台有家宽的海外机器,在那台机器上注册和登录claude。

分享下现在的纯手机端工作流。
九月底前我都是坐在电脑前开着terminal指挥着pi,跑多subagent,最后再自己看diff,提pr,经常一坐就是一天。 九月底,我工作流改成在手机端用hermes指挥pi,完全解决了久坐电脑前的痛苦,用到现在还挺舒服。 Hermes用旗舰模型(gpt-6-astra/opus-5.5),pi尽量不装插件,用中端模型(ds-v4.1-flash/sonnet/terra),二者间用a2a通讯。 hermes负责分析issues,拆分成多个小任务,然后给每个小任务创建worktree,并在里面派遣pi去完成小任务。 每个pi完成任务都会通知hermes,由它判断提pr还是返工给pi。基本逛一天景点,或一觉醒来十几个pr搞好了,舒服得很。 就是过程太黑盒了,心路历程有点像早期的vibe coding,那会diff至少自己会看一下,现在diff也黑盒,完全交给旗舰模型,属于盒中盒了。 如果没数据焦虑,其实可以直接用grok-bot或者chatgpt-dot,开箱即用,里面内置了grok-cli和codex,原生agents通讯。弊端就是数据不在本地,有监管,万一被封号一切归零。