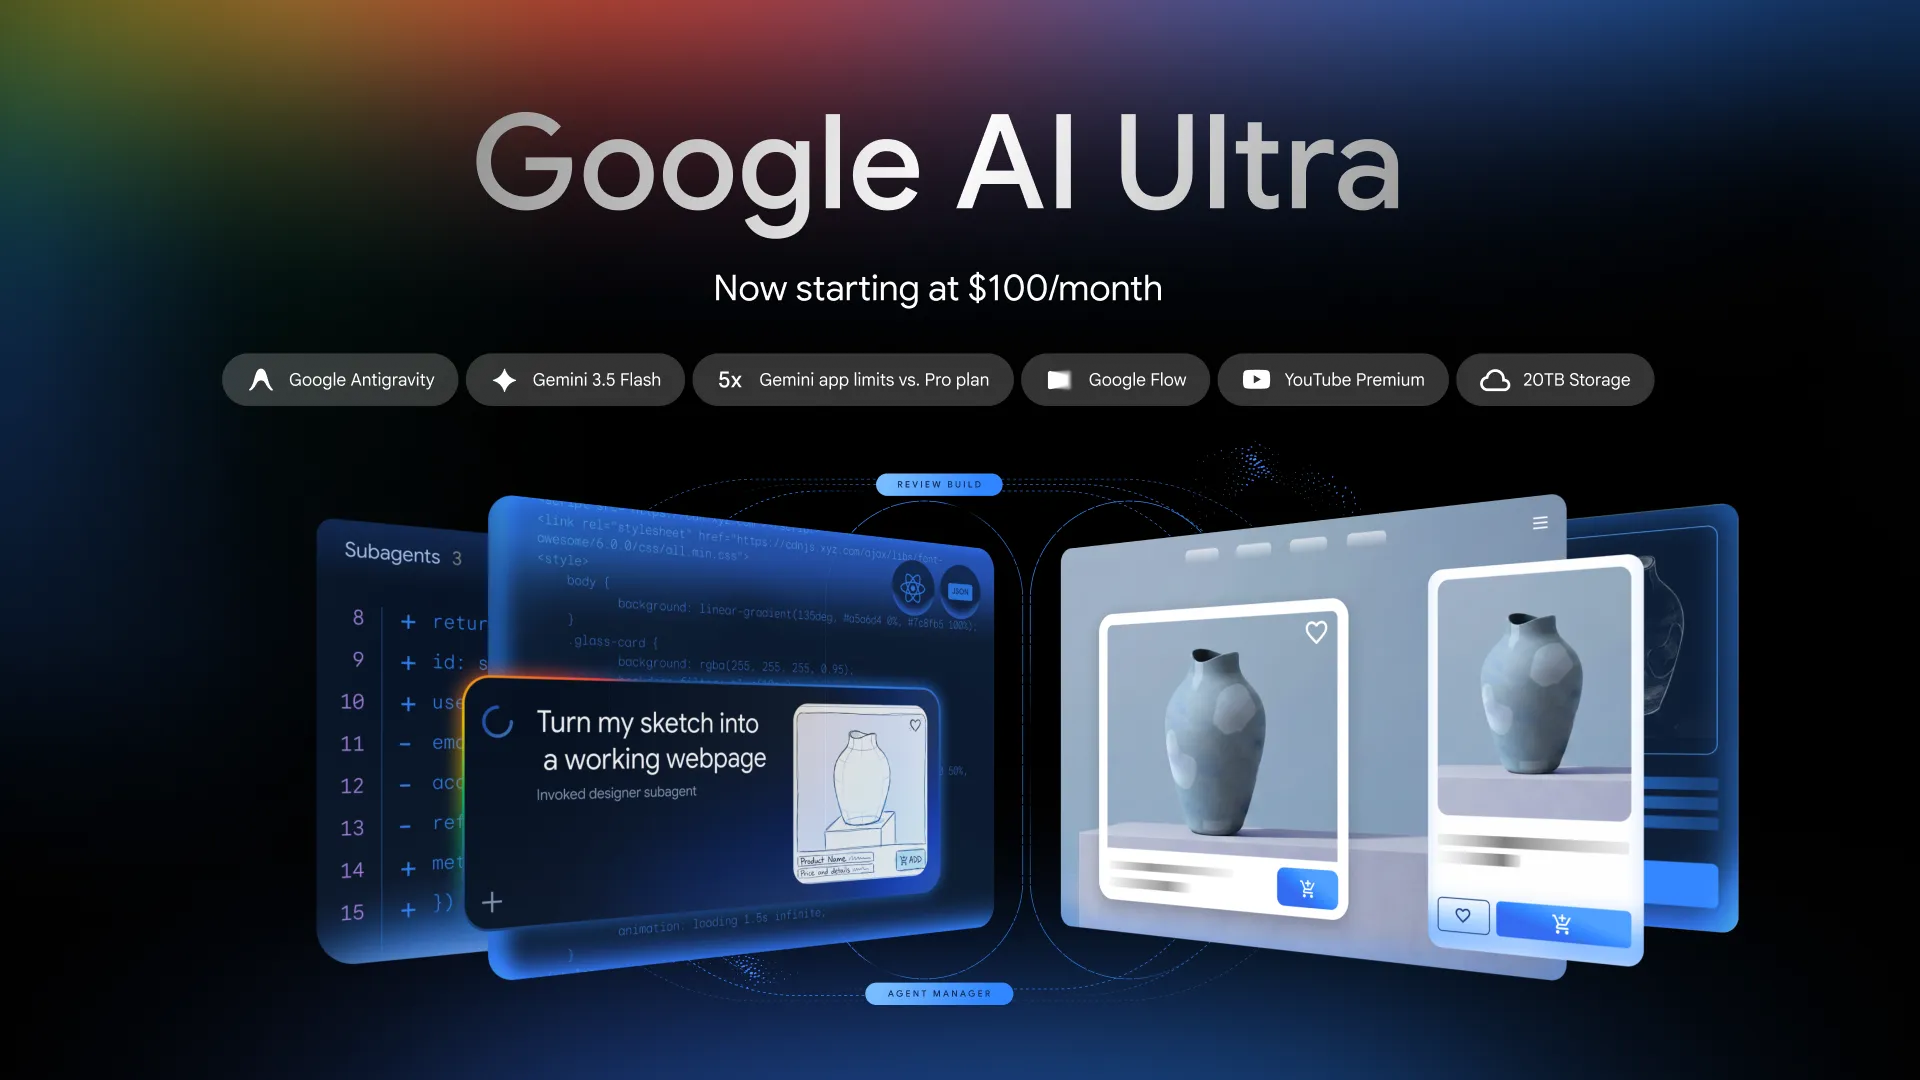
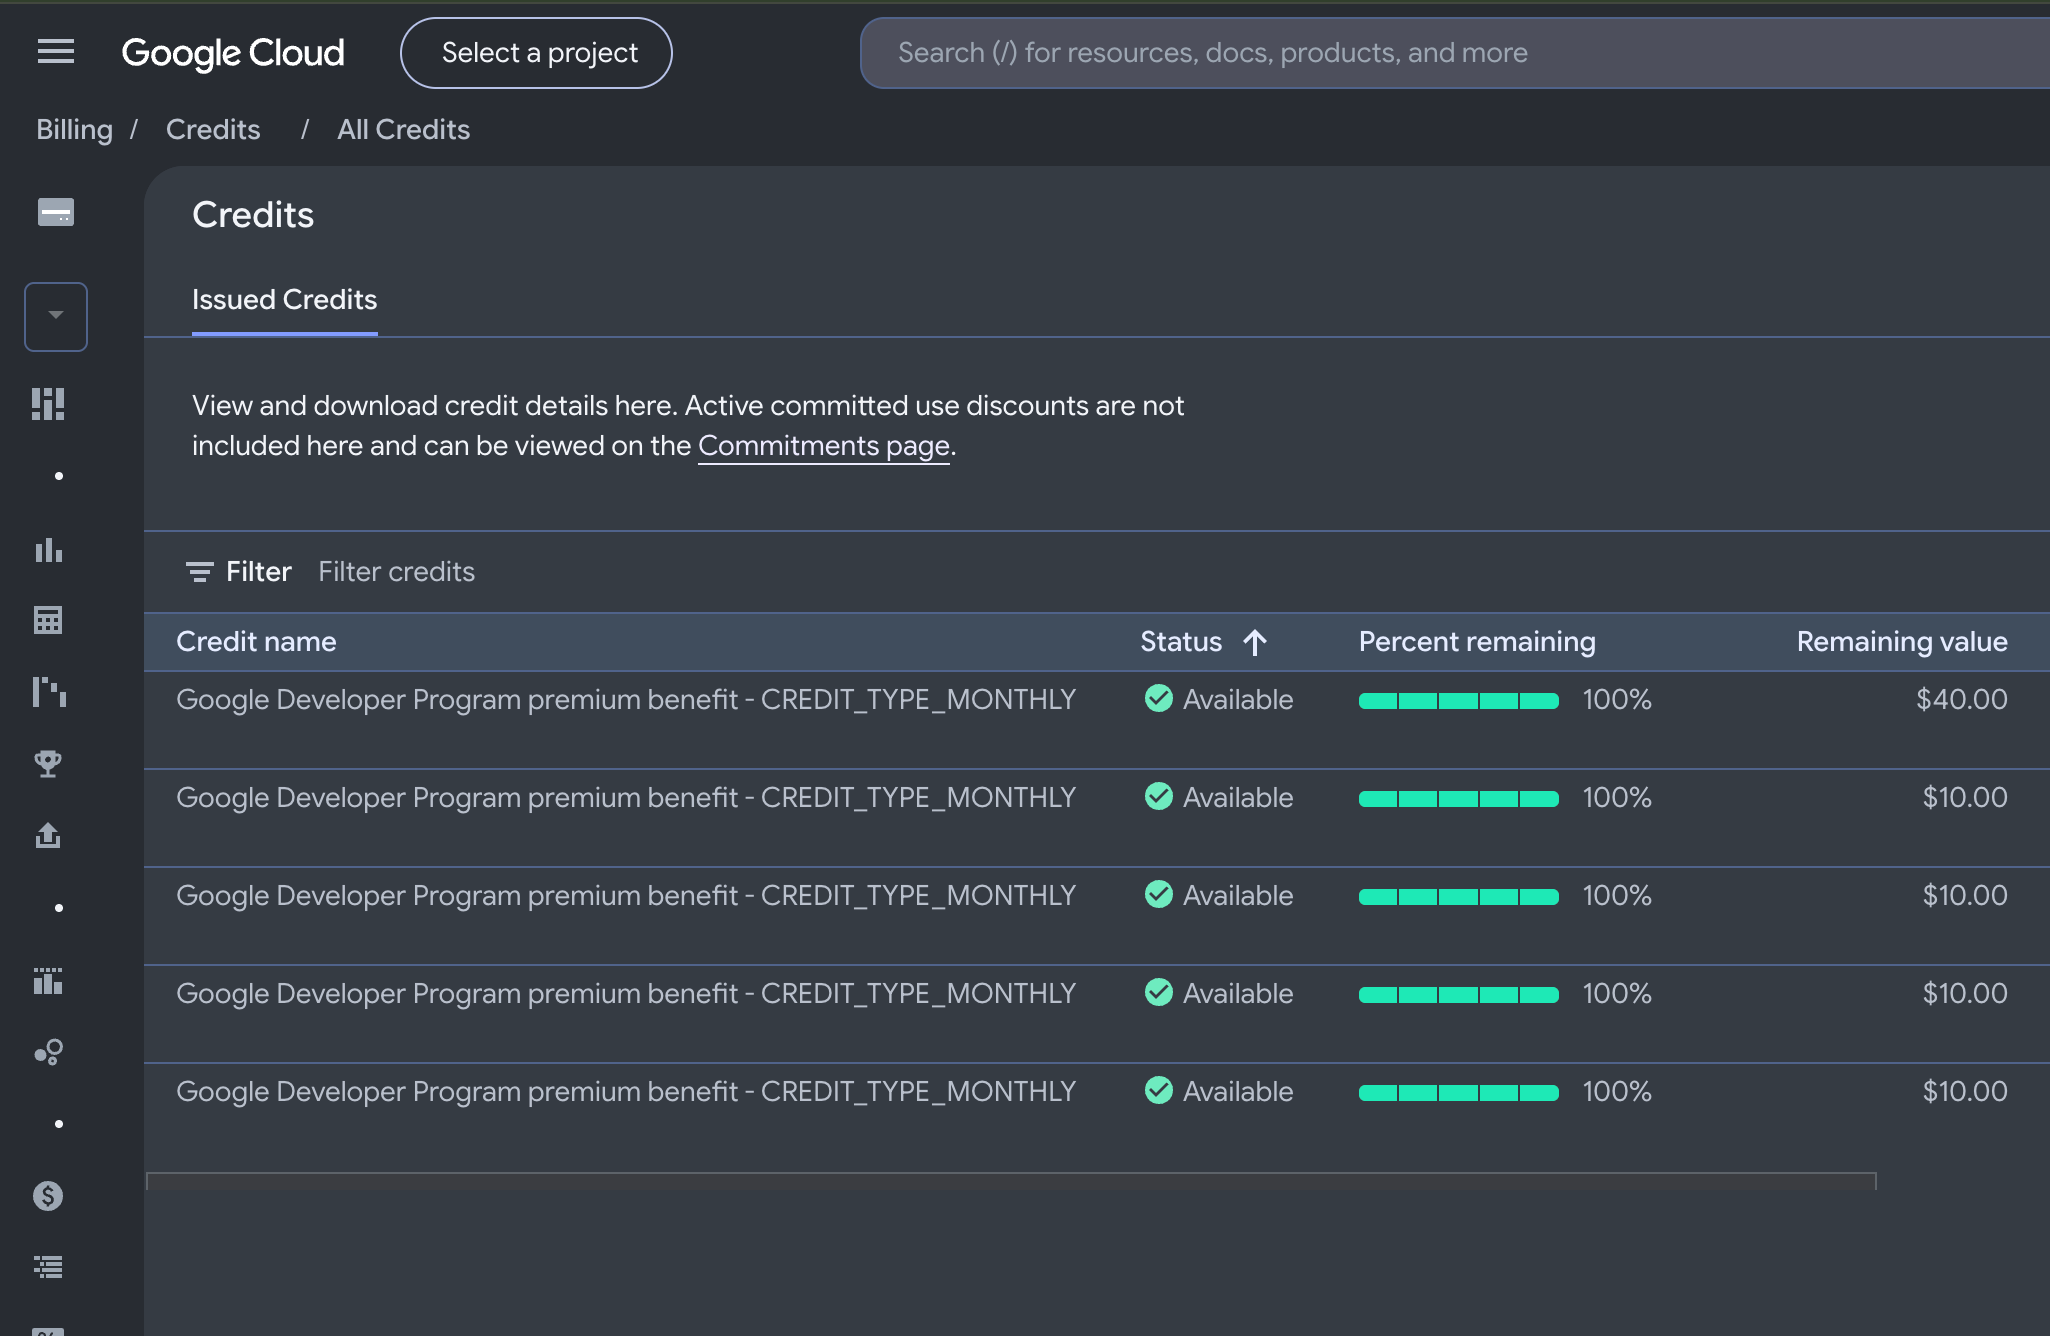
浩伊 18h Google AI Ultra 被低估了。 开通了Google AI 的天花板,我感觉还挺值。$99.99(5x) / $199.99(20x),每月送 $40/$100 cloud赠金,可以API调用Gemini。相比新用户$300赠金,ultra的赠金还支持第三方模型(claude、grok、deepseek、kimi等)。相当于半价订阅ultra。 gemini app里支持 Gemini 4 Argon、常驻智能体Gemini Spark;Flow里有1-2.5 万积分能生成大量视频、Flow Music 每个月 6000 首歌能商用;antigravity里能用Gemini 4 Argon,周积分也管饱,就是五小时限制太恶心了。 还有一些常规权益,20-30TB 云存储、YouTube Premium、Home Advanced、Health AI 教练等等。 展开
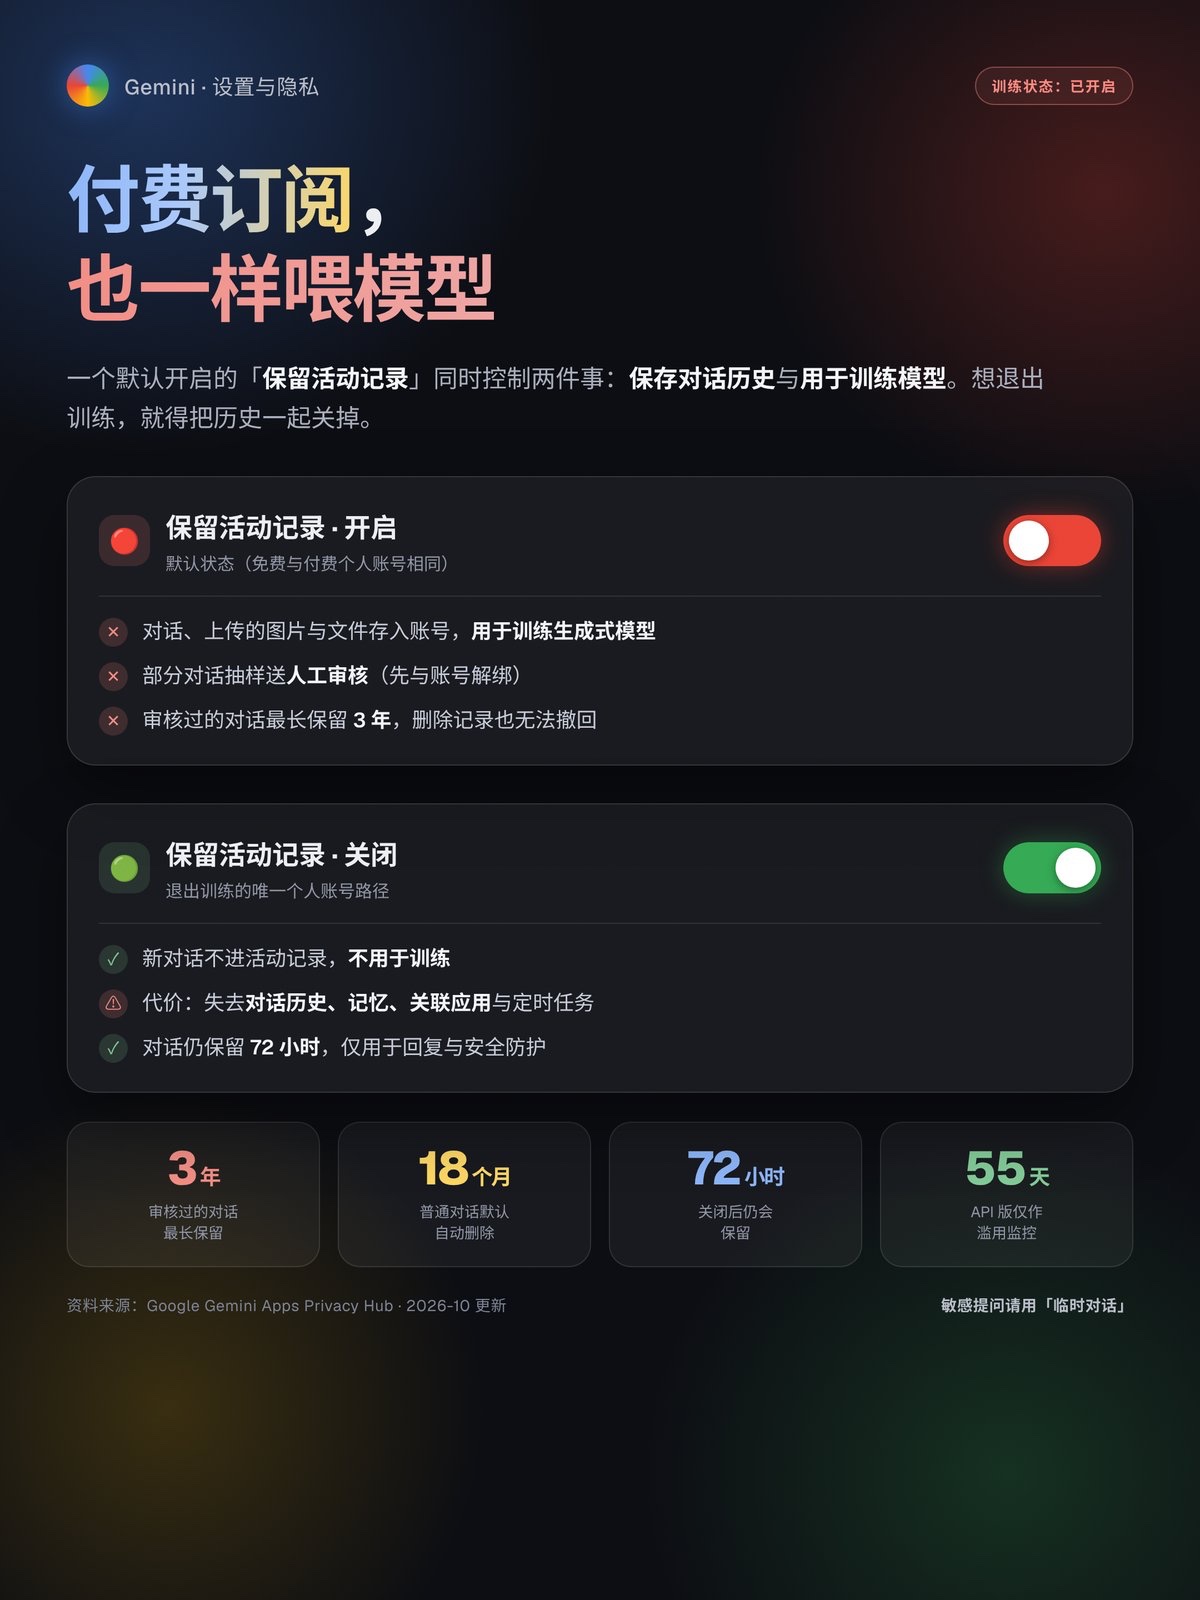
浩伊 1d Gemini被爆用拿所有用户数据训练模型。 Google挺离谱的,Google 把"训练数据"和"对话历史"绑在同一个开关「Keep Activity」上。 开着=默认喂模型(付费用户也逃不掉),关掉=退出训练但顺带丢了对话记忆和关联应用。 敏感内容记得用「临时对话」。 展开
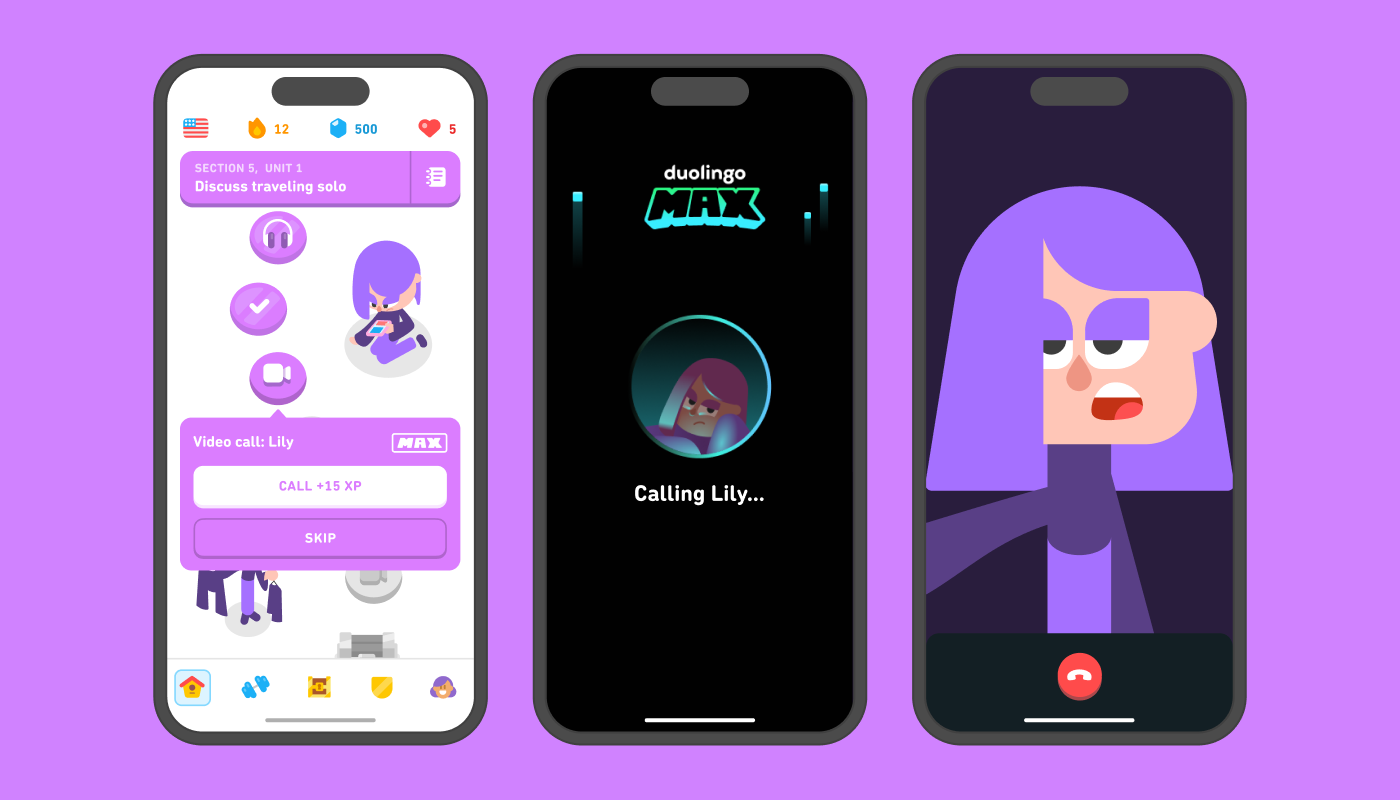
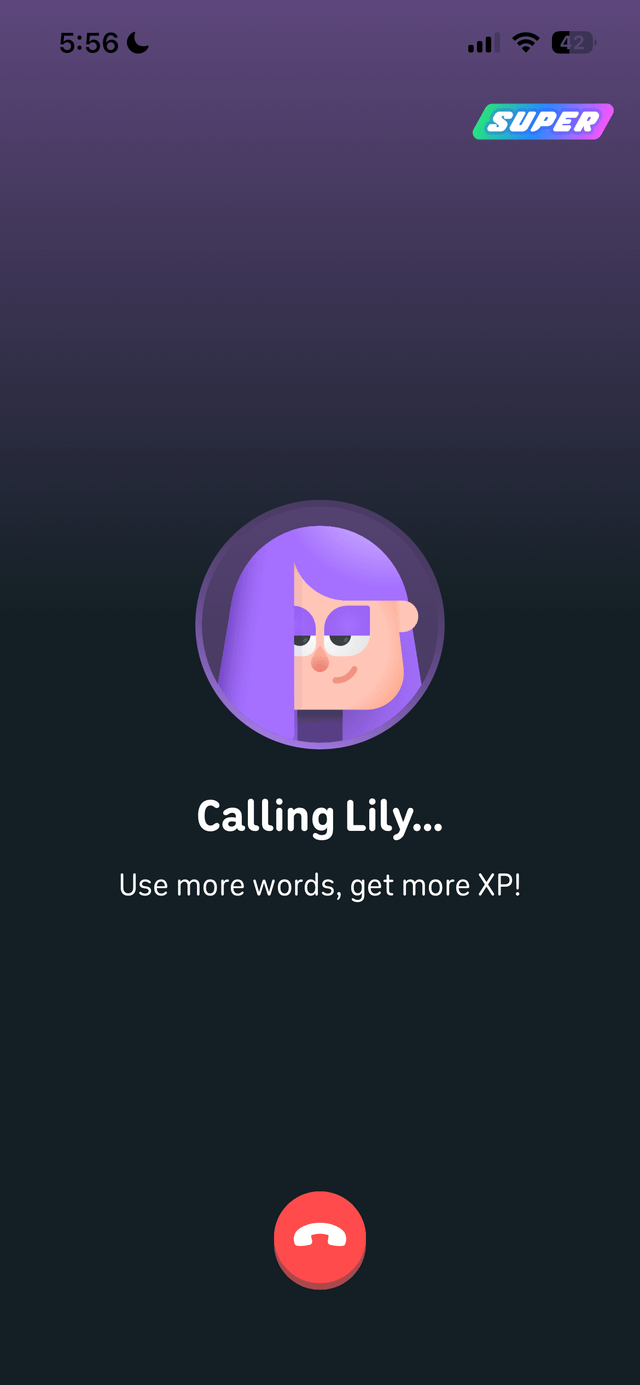
浩伊 1d 多邻国把 AI 视频通话从 Max 下放到 Super 了。 Video Call 能和角色 Lily 实时开口对话,她会接话、追问,比做题更像真聊天,练口语很实用。 • 新开 Super 已可无限次用,老用户年底前全部开通 • Max 本月停止新购,个人 Max 用户原价转为 Super 家庭版 • 每通成本从 $0.30 降到不到 $0.01,主要是换成了开源模型 目前支持英、法、西、意、德、葡 6 门课。 展开
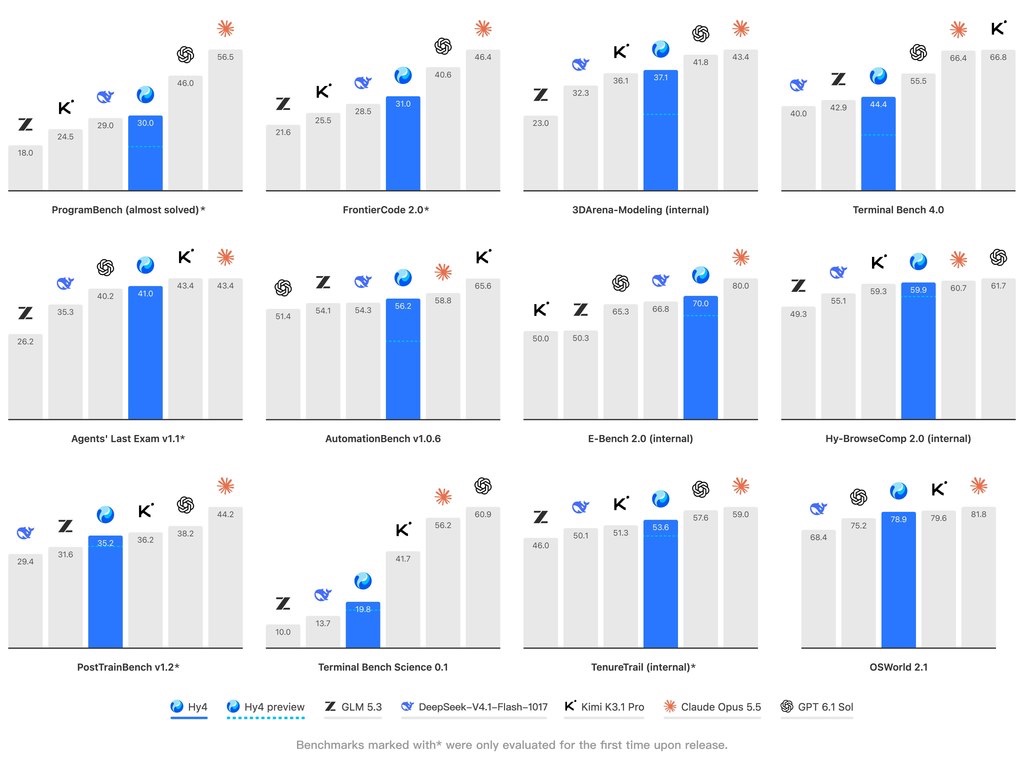
浩伊 1d 腾讯 HY4 正式版来了。 更强、更稳、更便宜的开源旗舰模型。 视觉理解首次登场,图表/数学/细粒度图像全部能精准无误识别。 会"用电脑"了,Blender、CAD、GUI/CLI 都能操作。 标准价(每百万 tokens) - 输入:约 $0.90 - 输出:约 $2.70 - 缓存输入:约 $0.045 另外HY4 Flash也即将发布,性价比更高。 限时优惠 - 11 月 4 日–15 日:WorkBuddy、CodeBuddy 免费 - 腾讯云 TokenHub 5 折,持续到 2026 年 12 月 31 日 展开
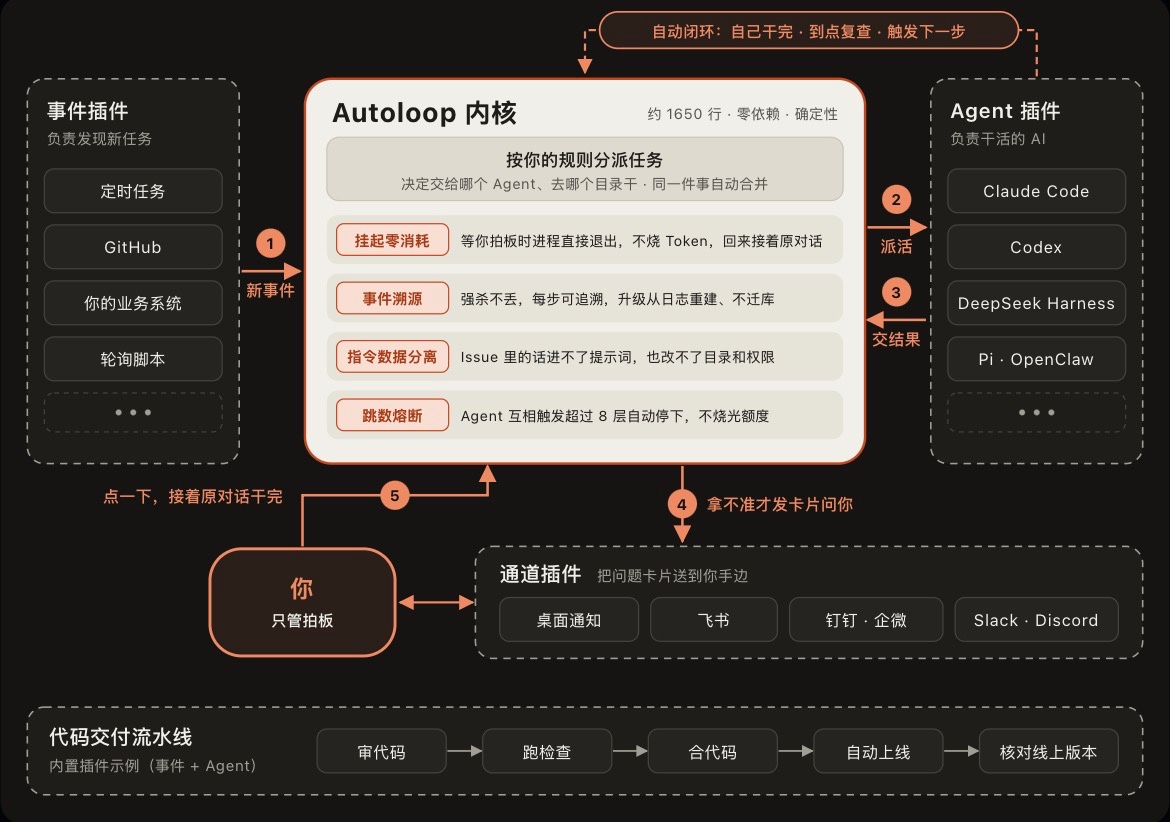
浩伊 1d 命令行 Agent 必须人守着终端? 这的确是个痛点,我是通过A2A来避免久坐终端前。 现在有个开源项目,它让命令行agent在后台自己接活、自己干到底,拿不准才通过渠道(飞书、slack、discord等)发卡片找你拍板。 Claude Code / Codex / Pi 等命令行agent都能接入。 🔗 github.com/KKKKhazix/agent-autoloop 展开
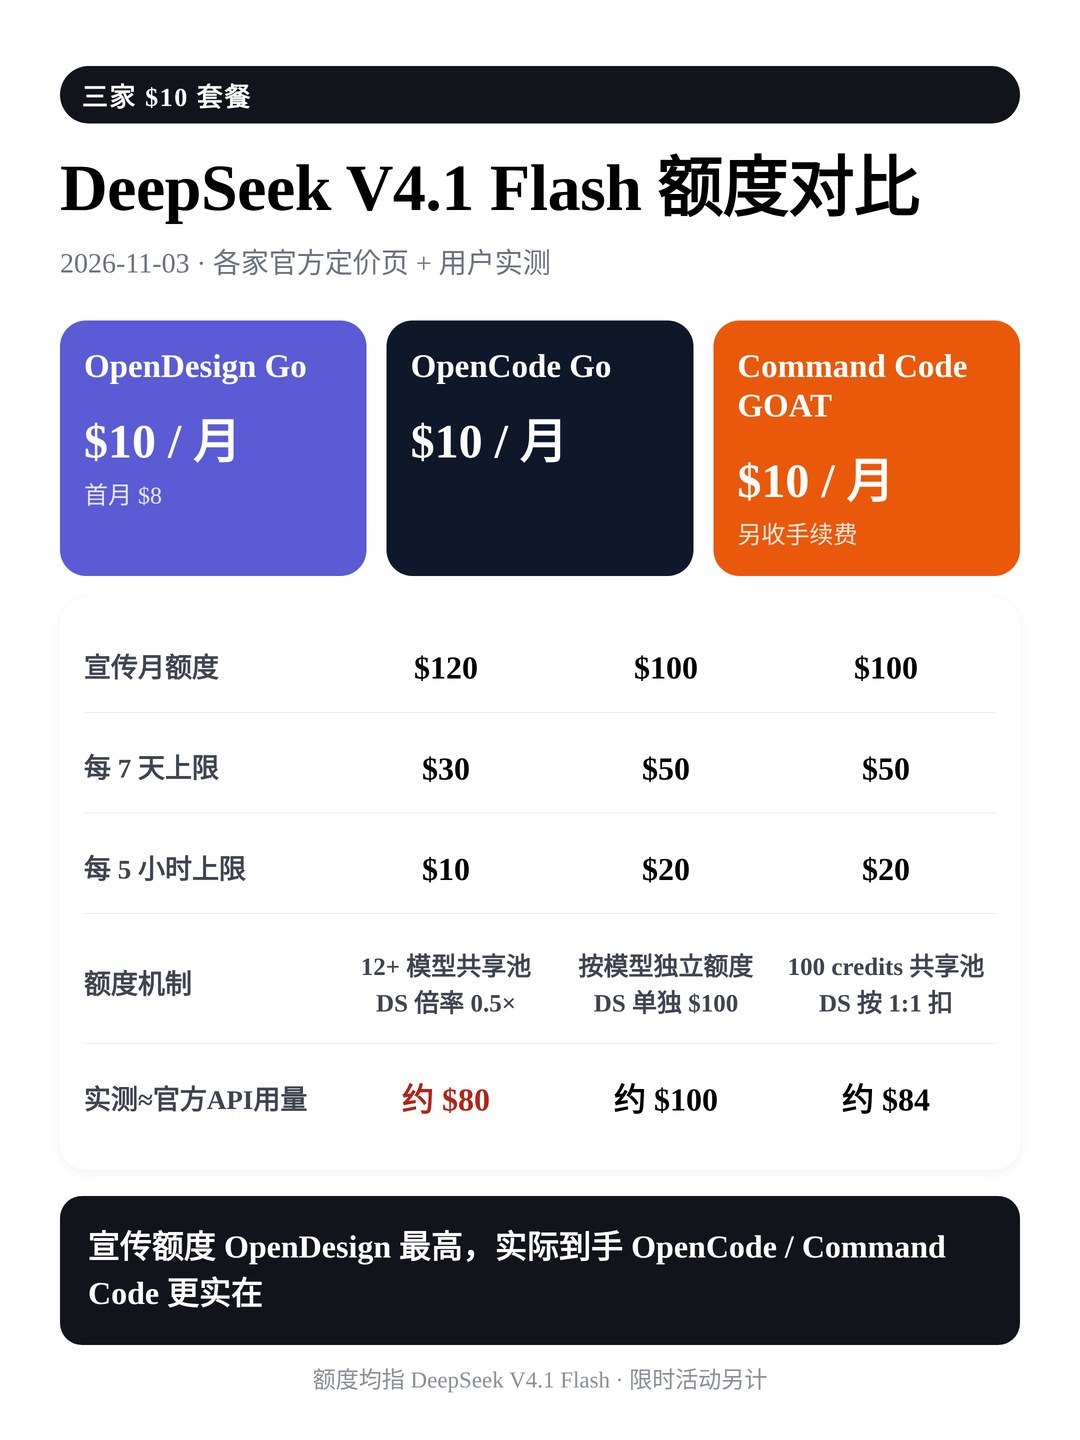
浩伊 2d 三家$10套餐对比。 上条贴子说旗舰模型用撮合站,价格低至一折左右。但旗舰模型跑subagent或日常agent还是太奢侈。 只要不搞开发,不搞科研,日常最合适的模型还是Artificial Analysis Intelligence 分数在30左右这档(deepseek-v4.1-flash),性价比最高。再往上就是40分档(Kimi K3.1 Pro),价格翻了十倍。 目前这三家$10套餐调用ds最优惠,OpenDesign Go 宣传给 $120,OpenCode Go、Command Code GOAT 都宣传给 $100。 但 OpenDesign 是 12 个模型共享的池子,5 小时只给 $10;另两家是 DS 独立额度,5 小时 $20。 展开
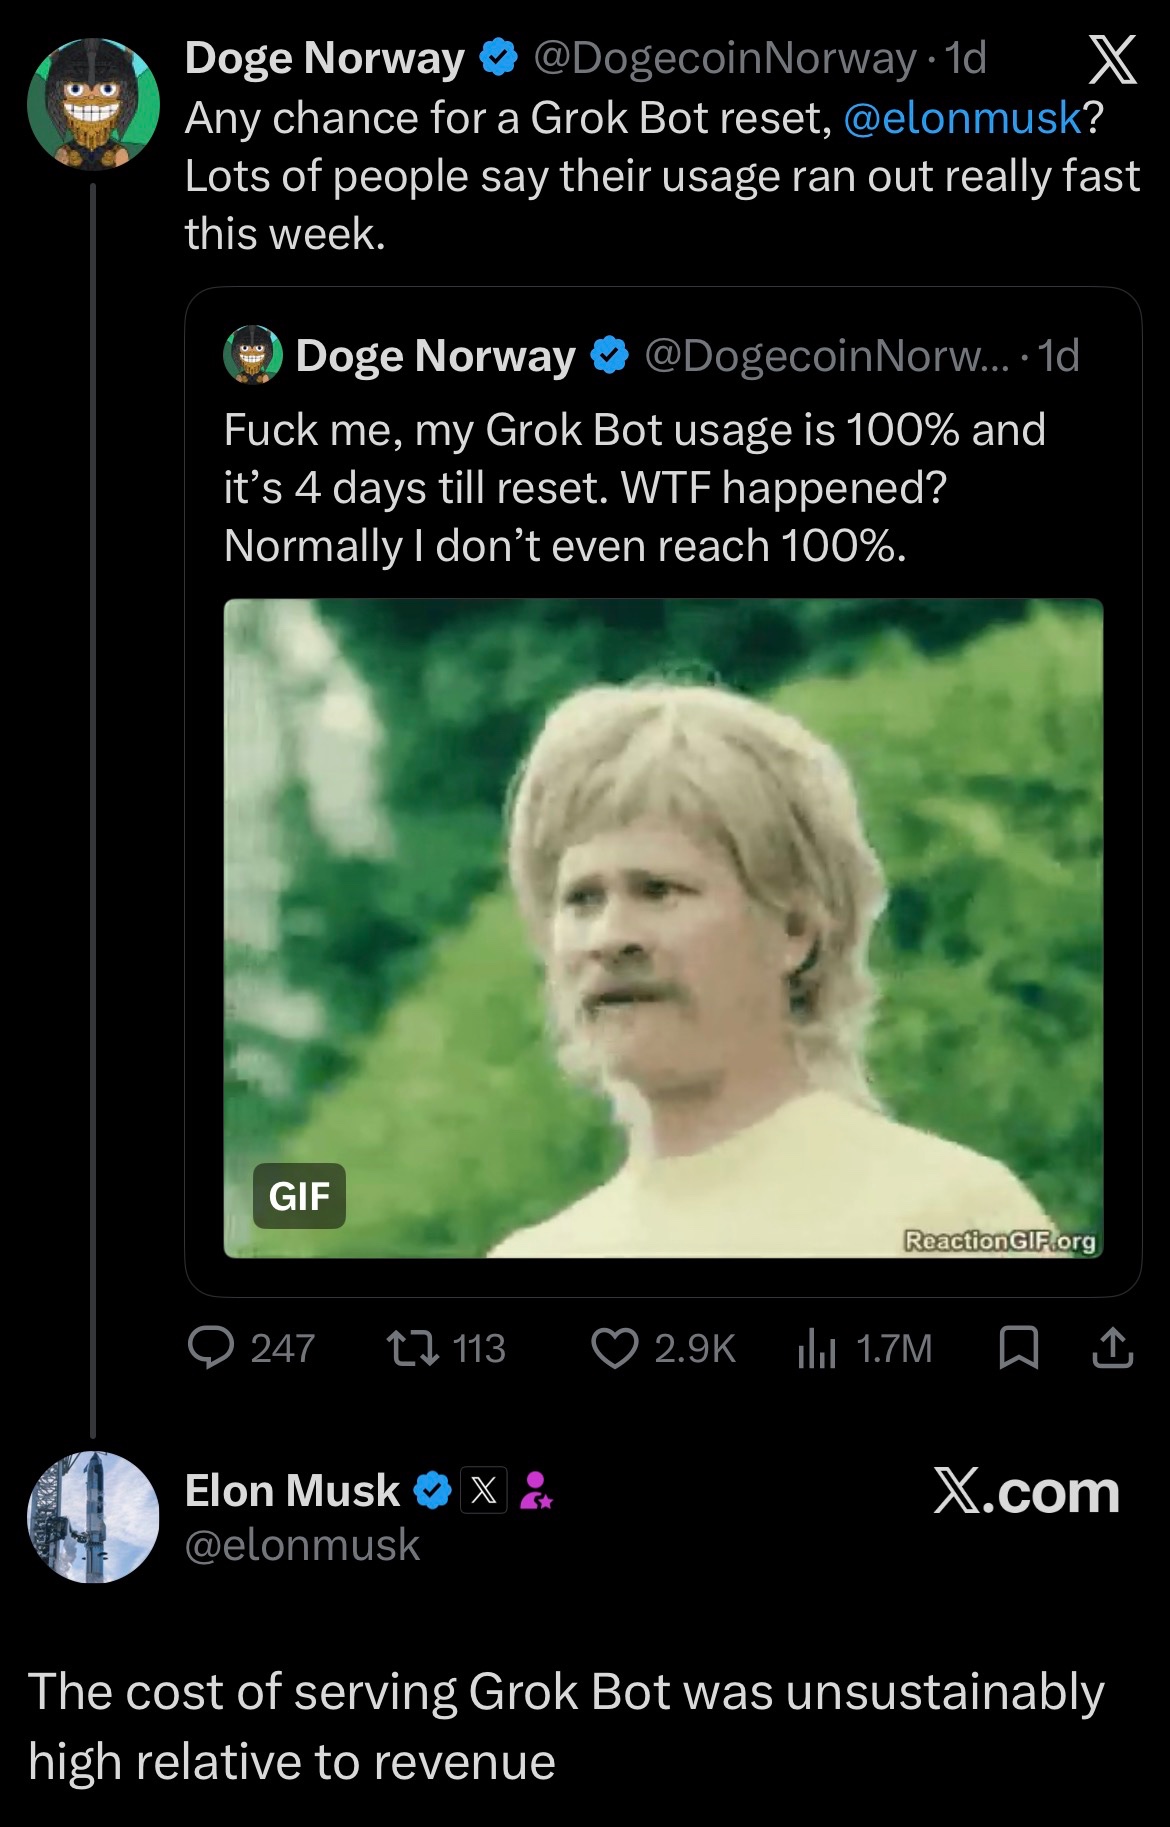
浩伊 2d SpaceX 悄悄砍了 Grok Bot 的用量额度。 不少用户一觉醒来发现本周配额直接从 50% 跳到 100% 用满,自己却没动过。 马斯克在 X 上确认这不是 bug,他的原话是“Grok Bot 的服务成本相对营收高得不可持续。”。 看来grok-bot成本确实高,不过我注意到配额已经恢复到了之前版本,昨天显示已用50%,今天降成30%。 展开
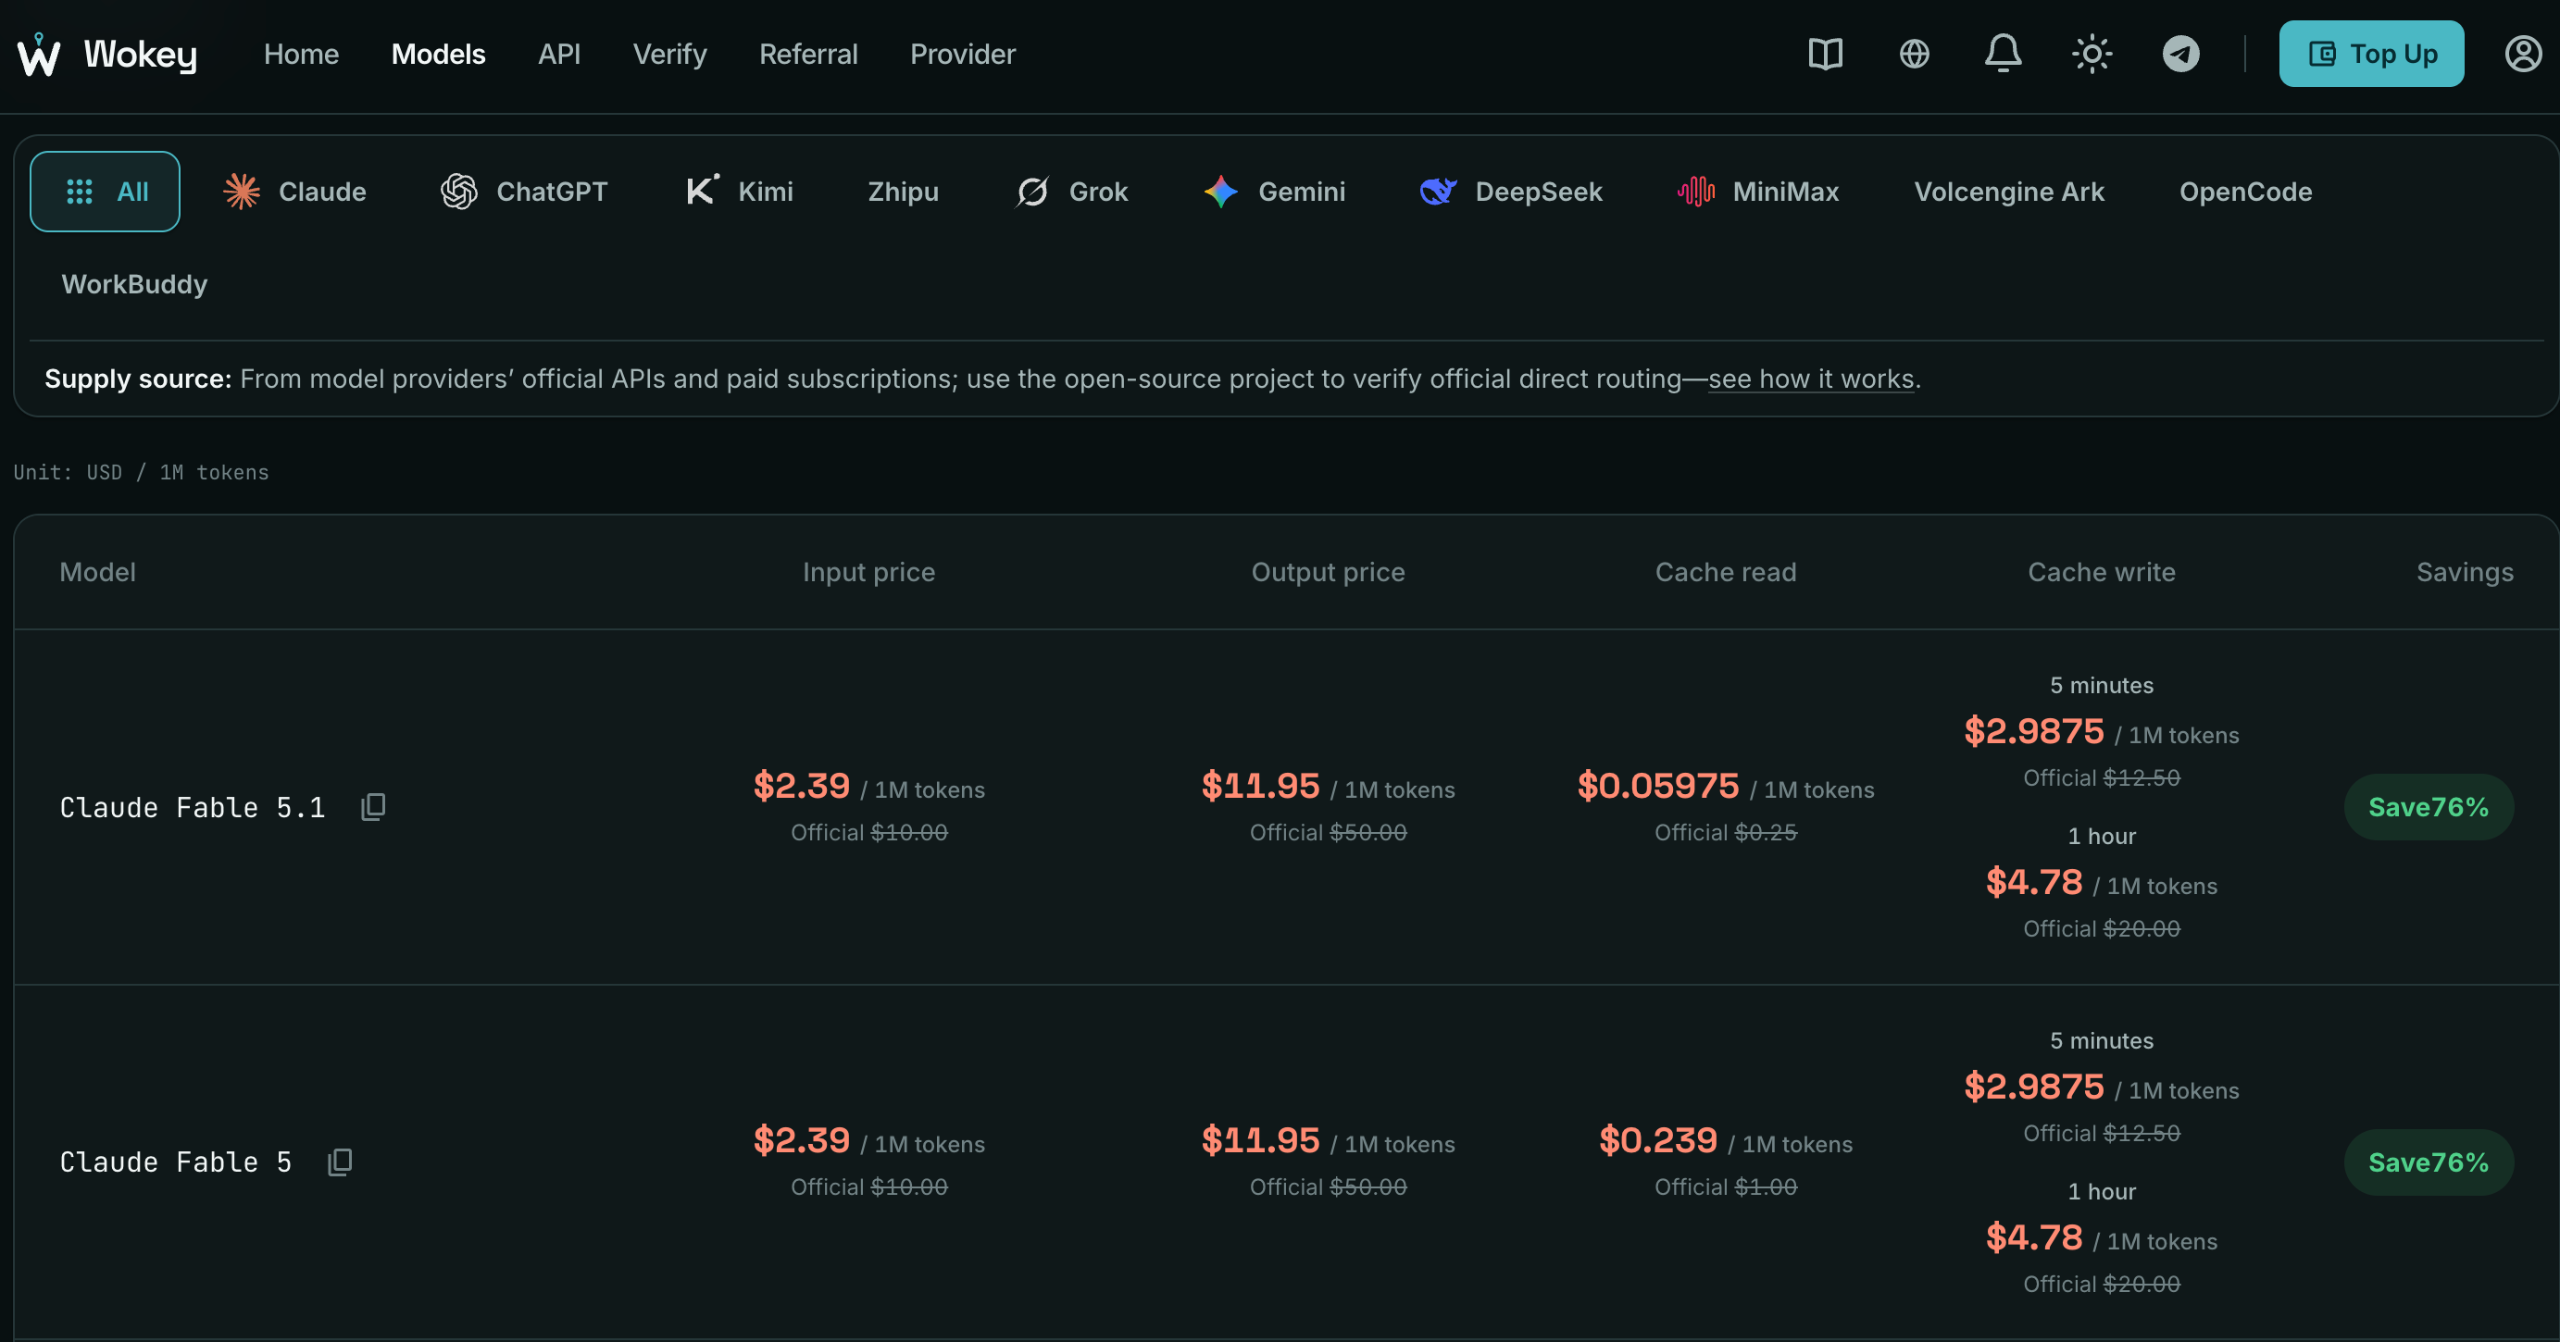
浩伊 3d openrouter拼多多版来了。 wokey是一家大模型撮合商,将用不完套餐的用户与套餐不够用的用户撮合在一起,抽取20%撮合费。 前者提供套餐额度可获得80%的收益,后者调用大模型最多可省官方API价格的90%。 我主要用它调用旗舰模型,保真且划算,不用折腾订阅,调用便宜模型不如中转站的价格便宜。 🔗 https://wokey.ai/r/GKT1C78R 展开
浩伊 3d 美团 LongCat-2.5发布了。 1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。 展开