如何低成本搭建自己的多模态数字人
更多动态
免费创建音画同步的“数字演员”
GAGA-1 是首款将声音、嘴型与表情一次性生成的 AI 视频模型,解决了传统 AI 视频口型与情绪脱节的问题。 1️⃣ 音画同步生成 模型采用 co-generation 架构,类似人类一次性完成说话与表情,声音波形与面部动作同步输出,无需后期对齐。 2️⃣ 情绪与场景 支持还原失望、愤怒等复杂微表情,也能一次性生成双人对话场景,无需拼接。 3️⃣ 低成本高效率 目前免费使用,上传图片与台词 Prompt,3-4 分钟即可生成 10 秒 720p 视频。 🔹 适合短剧、虚拟主播、NPC 对话等场景。当前版本对大幅度肢体动作支持有限,过长台词可能“吞字”。未来官方计划开放自定义音频与固定音色功能。 官网: http://gaga.art
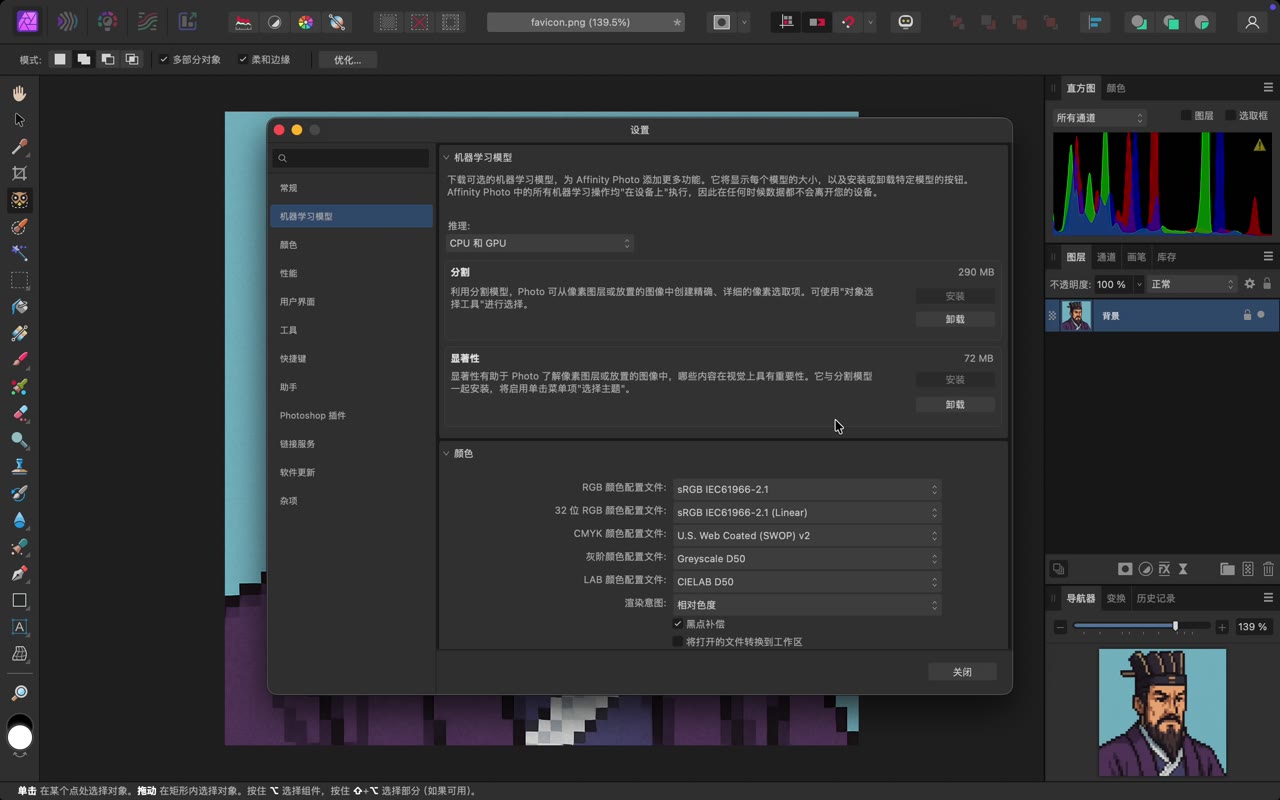
Affinity Photo 新增机器学习功能,永久免费使用AI
。该功能支持本地化处理,无需联网,确保数据隐私,用于提升图像主体与对象的选择精度和速度。 对象选择工具 (Object Selection Tool): 基于分割模型,自动识别并选择图像中的人物、动物、建筑等对象。模型大小约 290MB。 选择主体功能 (Select Subject): 基于显著性模型,一键智能识别图像中最突出的主体。模型大小约 72MB。 本地处理: 所有 AI 运算均在设备本地完成,不上传用户数据,保证隐私安全。
美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。