0 成本锁定 Adobe Photoshop Web 版一年权益,立省 ¥1700+ 订阅费
通过 Google 官方渠道利用 Chrome 扩展解锁云端修图能力,解决跨设备协作与临时轻量编辑需求。
传送门: goo.gle/3Xbwfzo
#生产力工具 #设计提效 #Adobe #WebAssembly #羊毛
0 成本锁定 Adobe Photoshop Web 版一年权益
更多动态
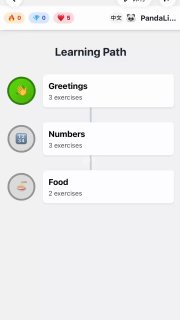
我用同样的prompt在灵光App搭建了学习中文的应用。
和Gemini3相比,你更喜欢哪个?
此时不换 Claude Opus 4.5,不仅是在烧钱
,更是在用二流算力对抗一流工程难题 Anthropic 这一波把「顶配模型」打成了「普惠基建」,编程能力超越 GPT-5.1 且 API 成本暴降 66%,这是目前大模型领域性价比最高的时刻。 🔹 推理强度(Effort)参数化:按需分配智商 原理类似人类的“快思考 vs 慢思考”。遇到 RAG 无法解决的复杂逻辑,调高强度让模型多“想”一会儿。 ◦ 开发者 MVP 配置: 务必测试 Effort 参数。设为 Medium 档位,性能持平 Sonnet 4.5,但 Output Token 消耗狂降 76%;设为 High 则能解决模糊需求,性能超越 Sonnet 4.5 约 4.3%。 🔹 SWE-bench 霸榜实战:超越人类直觉 准确率 80.9%(击败 GPT-5.1-Codex-Max)。实测中它最大的进化是「工程直觉」:不再需要保姆级 Prompt,能像 Senior 工程师一样在代码重构中自动处理歧义、权衡取舍。 🔹 计算机操作(Computer Use)升级 新增 Zoom Action(缩放操作),解决了上一代看不清密集 UI 和小字体的痛点。对于做自动化测试或 RPA 的朋友,现在可以精确识别复杂界面元素了。 🔗 官方日志:https://www.anthropic.com/news/claude-opus-4-5 #ClaudeOpus #AI工作流 #降本增效 #LLM开发 #编程效率

美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
