OpenAI 还没动静,DeepSeek 先把“推理成本”打到了地板价
更多动态
字节刚发布的「豆包手机助手」不仅是聊天机器人
,而是直接嵌入底层 OS 的数字员工,真正实现了从“教你怎么做”到“替你做完”。 它的核心逻辑是用 VLM(视觉语言模型)识别屏幕 UI,配合模拟点击实现: 1️⃣ 全网比价闭环:对它说“买最便宜的某物”,它自动遍历淘宝/京东/PDD,领券比价并填好订单,你只需最后按指纹支付。 2️⃣ 工作流自动化:这是杀手锏。一键识别微信群杂乱文件 ➝ 按类型归档打包 ➝ 发送至企业微信。以前手动要半小时,现在仅需几秒。 3️⃣ 屏幕感知(Screen Awareness):按侧边键,它能读取当前聊天记录帮你拟定高情商回复,或者语音指挥相册修图,不用再记复杂的二级菜单。 ⚠️ 目前首发于努比亚 M153(工程机),本质是利用 Android 无障碍权限(Accessibility),在隐私敏感度极高的当下,建议先观望其权限管理机制再主力使用。 #AIAgent #豆包手机助手 #自动化 #生产力工具

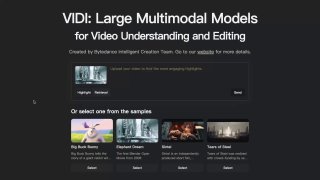
字节跳动 11 月发布的 Vidi2,彻底解决了长视频从“模糊理解”
到“精准定位”的难题,让 AI 剪辑真正进入工业化可用阶段。 🔹 视频版 Ctrl+F 核心突破是 STG(时空定位)。传统模型像 RAG 一样只能模糊检索“大概讲了什么”,Vidi2 能实现端到端输出:不仅知道“有猫”,还能精确给出“第 14 分 20 秒、屏幕左下方”的 Bounding Box 坐标。 🔹 实战优于对话 在 VUE-STG 基准测试中,其定位精度(vIoU)比 GPT-5 和 Gemini 3 Pro 高出一倍。这说明它不适合“陪聊”,但极适合“干活”——比如自动识别主角,将 1 小时横屏素材无损裁切为适应手机端的竖屏短片(Smart Reframing)。 🔹 从理解到创作 基于 Gemma-3 架构,支持超长上下文(>1小时)。丢给它一堆杂乱的 Raw Footage,它能结合音频(如警笛声)与视觉信号,自动梳理故事线并生成剪辑脚本,而非简单的切片。 🔗 项目主页: https://bytedance.github.io/vidi-website #AI工作流 #视频自动化 #Vidi2 #多模态 #生产力工具

美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。