刚写完脚本准备配音,结果随手测了下 Google 刚更的 Gemini 2.5 TTS,手里的咖啡瞬间不香了。🤯
简单说:这玩意儿不是在“读”,是在“演”。
我以前最烦 TTS 那种“毫无波澜的朗诵腔”。但这次 2.5 版本有个离谱的Prompt 导演模式。
我试着输了一段:“从紧张不安开始,慢慢加速到兴奋高潮”,它居然真的顺着情绪弧度变了!尤其是 Enceladus 这个预设声音,连那种长句子讲完后的“呼气声”都有,听得我起鸡皮疙瘩。
实测下来:
懂梗:它知道讲笑话的时候哪里该停顿(抖包袱),讲动作戏的时候语速会自动变快。
混语大神:中英夹杂的文案,终于没有那种尴尬的“译制片腔”了,切换非常丝滑。
便宜:Pro 版每百万音频 token 才 $20,相比隔壁竞品,简直是做慈善。
⚠️ 但是这里有个大坑
别高兴太早,这货在念数字、具体地址的时候偶尔会翻车,遇到复杂的人名也容易嘴瓢。如果你是做那种精准度要求极高的医疗/财经内容,建议多听几遍或者手动微调。
这波更新我觉得是把“能用”变成了“好用”。目前 Google AI Studio 还能免费白嫖试用,感觉离全面收费不远了。
#AI工作流 #独立开发 #GeminiTTS #内容创作
刚写完脚本准备配音,结果随手测了下 Google 刚更的 Gemini 2.5 TTS
更多动态
阿里这次开源的通义百聆(Fun-CosyVoice3)属实有点东西
,特别是在“白嫖”和“本地部署”这件事上,给独立开发者留了条活路。 实测下来,几个感觉最明显的点: * 轻得离谱:0.5B 的参数量,直接跑在我的开发本上居然不卡。官方说首包延迟降了 50%,体感就是刚敲完回车,声音就出来了,这就很适合做实时语音助手。 * 嘴替神器:最变态的是 Zero-shot 音色克隆。我随便录了段 3秒 的普通话,它居然能完美复刻我的音色去讲日语和英语。对于我这种想做 Global 内容但口语又烂的人,简直是救命稻草 🤯。 * 避坑指南:别信什么“完美接近人类”,在极度嘈杂的背景音下取样,克隆出来的声音还是会有明显的“电音感”。而且环境配置有点折腾,Python 依赖地狱警告 😤。 相比云端 API 按字符收费的肉疼,这种能塞进本地 Docker 的方案才是真香。 趁现在代码刚热乎,赶紧去 Pull 下来试试。 #AI工作流 #独立开发 #数字游民
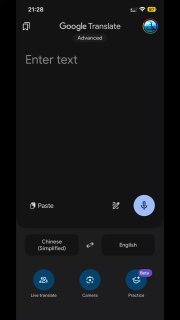
差点为了出国沟通方便去买那个两千块的 AI 硬件
,结果发现 Google 翻译偷偷憋了个大招。我本来是 DeepL 的死忠粉,对于 Google 翻译那种“机翻味”向来是嗤之以鼻的,但这波更新真的让我有点手抖。 我昨晚在星巴克测了一下。以前用 Google 翻译最怕遇到习语,比如我想跟葡萄牙朋友解释“stealing my thunder”(抢风头),旧版直接给我翻成“偷雷声”,场面一度非常尴尬 。这次接入 Gemini 后,它居然能读懂“潜台词”了,不仅翻译准了意思,连那种情绪上的微妙感都抓住了。感觉它终于不像个只会查字典的呆板机器人,而是个懂点人情世故的本地人。 最炸裂的是那个“Live translate”。我戴着杂牌有线耳机,直接开启实时语音。Gemini 2.5 Flash 的模型确实有点东西,隔壁桌在大声聊八卦,它居然能把背景噪音滤掉,只翻译我对面那个人的话。这种“给耳朵装外挂”的感觉,对于我们这种常年在外面跑的数字游民来说,简直是救命稻草 。 唯一的槽点是,这么好用的实时语音目前只在安卓首发,iOS 用户居然要等到 2026 年?库克看了都得摇头。 你们平时翻译工具用的啥?
美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
