再也不用对着黑底白字的命令行猜 Agent 在干嘛了。
更多动态
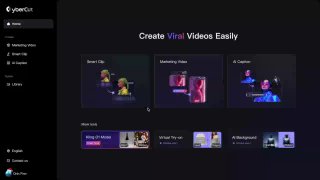
实测快手的 CyberCut,它把“手搓剪辑”变成了“流水线生产”
,帮我解决了长视频变现的痛点。 1️⃣ 智能切片:以前我剪播客切片要搞一天,现在扔进直播回放,AI 自动抓取高光时刻。最惊喜的是 Auto-Reframing,横屏转 9:16 时人物自动居中,不用我一帧帧调位置。 2️⃣ 文本化剪辑:逻辑像改 Notion 文档,删文字=删画面。对于我们非剪辑专业出身的人来说,这种“粗剪”效率提升肉眼可见。 虽然涉及部分领域术语时字幕还得人工过一遍,但整体比我之前用其他剪辑软件生成的速度体感要快一些 。 #AI工作流 #视频剪辑 #数字游民 #CyberCut #效率工具

本地跑小模型终于不再是“人工智障”了。
Liquid AI 刚出的 LFM2-2.6B-Exp,是我这周在旧款 Mac 上跑得最顺的“口袋大脑”,断网也能飞起。 1️⃣ 路子很野的“纯强化学习” 这模型完全跳过了 SFT(监督微调),直接用 Pure RL 训练。我实测下来,它的逻辑“直觉”出奇的好。特别是在处理 JSON 数据提取这种脏活儿时,指令跟随能力比我之前常用的 8B 模型还要稳,很少幻觉。 2️⃣ 老电脑的救星 它用了混合架构(卷积+注意力),简单理解就是“吃得少跑得快”。在高铁上信号极差,我用它配合 Obsidian 做本地 RAG 查文档,响应速度比 Qwen3 快了大概一倍,关键是风扇没狂转,续航没崩。 虽然它在 IFBench 上评分挺高,但毕竟只有 2.6B 参数。写写代码片段、改改邮件很爽,但如果你指望它写长篇深度研报,逻辑深度还是不如云端大模型,别神话它。 你现在本地部署主要用 Ollama 还是 LM Studio?👇 #AI工作流 #本地部署 #效率工具 #LiquidAI #独立开发

美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。