腾讯混元 Hy3 来了,Agent 能力同尺寸最强
Hy3 的总参数 295B ,每次推理只激活 21B。简单的快答,复杂任务才调度深层专家。256K 上下文,Apache 2.0 开源。
Hy3 的价格更接近 DeepSeek V4 Flash,输入 ¥1/百万 tokens,输出 ¥4,缓存命中 ¥0.25。OpenRouter 给了两周免费额度。
Agent 跑分方面,BrowseComp 84.2,逼近 GPT-5.5(84.4)。ClawEval 68.5,压过 DeepSeek V4 Pro(62.4)和 Qwen 3.7 Max(65.2)。
我实测对比了下 Deepseek-V4-Pro、K2.7、M3,Coding能力可能不是最强的,但 agent 能力合格,价格上也很有优势,非常适合作为通用 agent (openclaw、hermes等)的模型。
openrouter: openrouter.ai/tencent/hy3:free
腾讯混元 Hy3 来了,Agent 能力同尺寸最强
更多动态
SpaceXAI 推出了 Grok 4.5,能上桌了
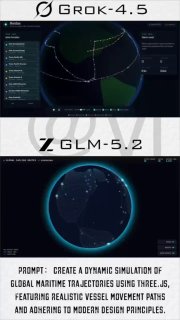
Grok 4.5 在编码和工程任务上对标前沿,与 GPT 5.5、Claude Opus 4.8 打得有来有回。SWE Bench Pro 64.7%,首次超了 GPT 5.5。实测应该和 glm-5.2 一档。 价格方面,$2/M 输入 tokens,$6/M 输出 tokens,跟同级别的模型比算便宜的。
Grok + 声音克隆,一个假人替我赚了 3000 美金
Grok Super 的额度一直用不完,每个月一堆视频额度,放着也是浪费。然后我试着搞了个擦边号。 Grok 生成穿搭视频,脸是同一张,身材是同一个,换衣服、换场景就行。声音这块我用的自己写的声音克隆 skill 。视频画面像同一个人,嘴一张声音也是同一个。 流量比我预想的要好,一周几千粉,不到一个月过万。然后就收到了一些 BD 私信,基本都是带货广告。 复刻这套也很简单,声音克隆skill我开源了,视频生成用 Grok Super 或其他工具都行。剩下的,就是执行力。 github: https://github.com/haoyiyin/clone-voice
美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
