Agent 搜索、爬虫 0 成本方案
我最近在用 wigolo 这个开源项目,把搜索、抓取、爬取、抽取、研究这些功能全在本地实现了,不用 key、无任何云服务,数据不出设备。
让 agent 完全免费搜索内容,抓取网页,彻底摆脱 Firecrawl、Exa、Tavily、brave、jina 这些传统云端服务。对于普通用户,也不用去生成那些 API key ,配置环境变量。
github: KnockOutEZ/wigolo

更多动态
,用市面上不同 agent 工具,搭配不同的大模型,做了一次真实开发测试(非 benchmark 测试集),pi coding agent表现亮眼。 图表中,纵轴越靠上成功率越高,横轴越靠左成本越低。可以看到 pi 搭配顶级模型后任务成功率都保持80%以上,并且 token 消耗远远低于其他 agent 工具。 我也用了 pi 一段时间了,搭配 grok-4.5 + DeepSeek-v4 和自己的工作流(主 agent 编排, subagent 并发、隔离上下文),产出成果很少出现返工、运行速度非常快,终于不用刷手机等结果了。 对了,主 agent 编排, subagent 并发将是 agent 趋势,最近不少 agent 工具开始支持这类工作流。

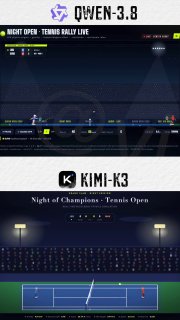
提示词: “用svg动画,创建一个真实的网球比赛,两名球员对攻,要符合物理规律,符合现实世界逻辑。” 不知道是不是 Qoder 的原因,我生成这张 svg 动画花了两小时。 Qwen-3.8 反复思考,计划花了四十多分钟,写文件+修 bug 花了一个多小时。 svg 动画效果挺完美的,有声音,底部参数栏显示解说、球速、击球次数、技术分析。Kimi-K3 则没有声音、底部参数栏有 bug ,不会实时显示。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
