更多动态
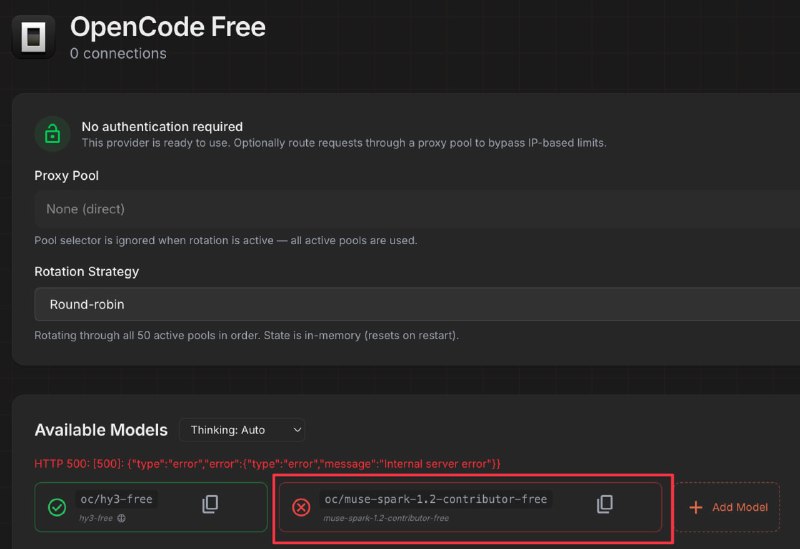
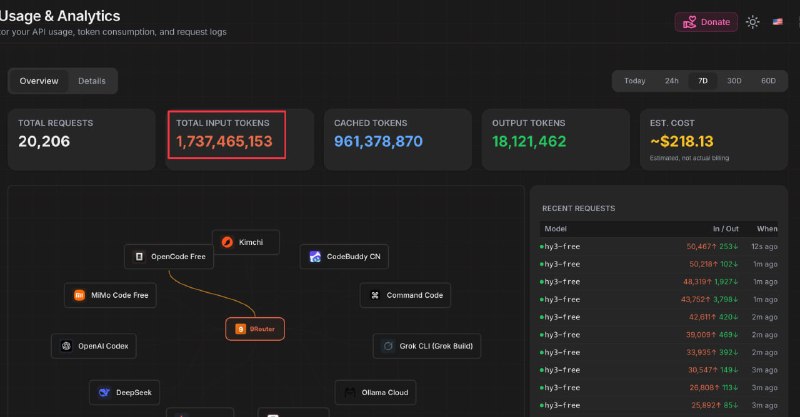
自从 8 月 16 日涨价后,这一周花了我一千多,而且 ds 主要还是兜底模型(fallback)。当然我的 token 消耗也多,所有模型加一起每周要 1B 多。 我主要面向 coding 场景,其他场景也可以参考。首先要专模专岗,不要所有场景都用一个模型,例如网络搜索(research)、本地搜索(explore)我就用免费的模型或者便宜的模型,只有计划、决策大方向、难点的任务我才会用第一梯队的模型。 所以现在至少需要两个模型,一个第一梯队的模型,例如 ChatGPT 和 Grok 的订阅。一个便宜或免费的模型,例如 Hy3 干杂活够用了。 目前我自己的方案是ChatGPT 和 Grok 双订阅用顶级模型 + commandcode 一美元订阅灵活调用顶级模型或便宜模型,最后再外加 50 个 IP 池轮询 opencode hy3-free 模型(每个 IP 每天有免费的额度,无需登录),以及 workbuddy 每天签到领积分低积分消耗调用 hy3 。

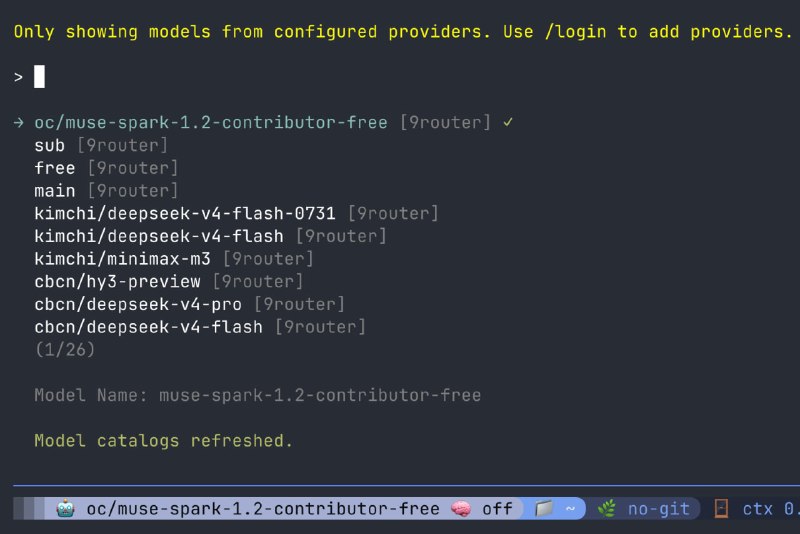
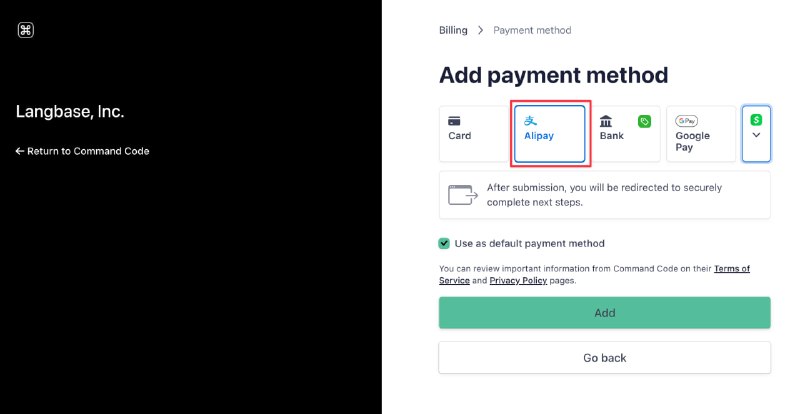
估计他们的中国用户不少,不然不会单开一个支付方式。不过 cmc 现在也有周额度限制,我这周大概跑了 150M 的 meta/muse-spark-1.2-contributor 就提示上限了。

1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。