零基础 8 分钟上线 H5。豆包 AI 编程更新,让非技术人员也能像做 PPT 一样交付网页
它把 AI 编程的重点从“辅助写码”转向“可视化交付”。
1️⃣ 多模态输入:支持自然语言、手绘草图、甚至上传 PPT 或 Word 文档直接生成。
2️⃣ 可视化编辑:核心功能。生成页面后,可直接拖拽组件、改配色。左侧画布与右侧代码同步高亮,降低了非技术人员的修改门槛。
3️⃣ 多 Agent 协作:内置“虚拟团队”,自动分配检索、视觉(AI 配图)、代码优化、多端预览任务。
🔹 适用场景:适合快速构建活动 H5、数据看板、营销落地页等前端应用。
🔹 注意:目前版本暂不支持数据库、用户登录等后端逻辑。
官方数据称 Python 补全准确率 89%,对中文指令理解较好。
官网:https://www.doubao.com/code/chat
#AI编程 #豆包 #低代码 #H5制作 #生产力工具
零基础 8 分钟上线 H5
更多动态
让 AI 视频生成“实时可控”
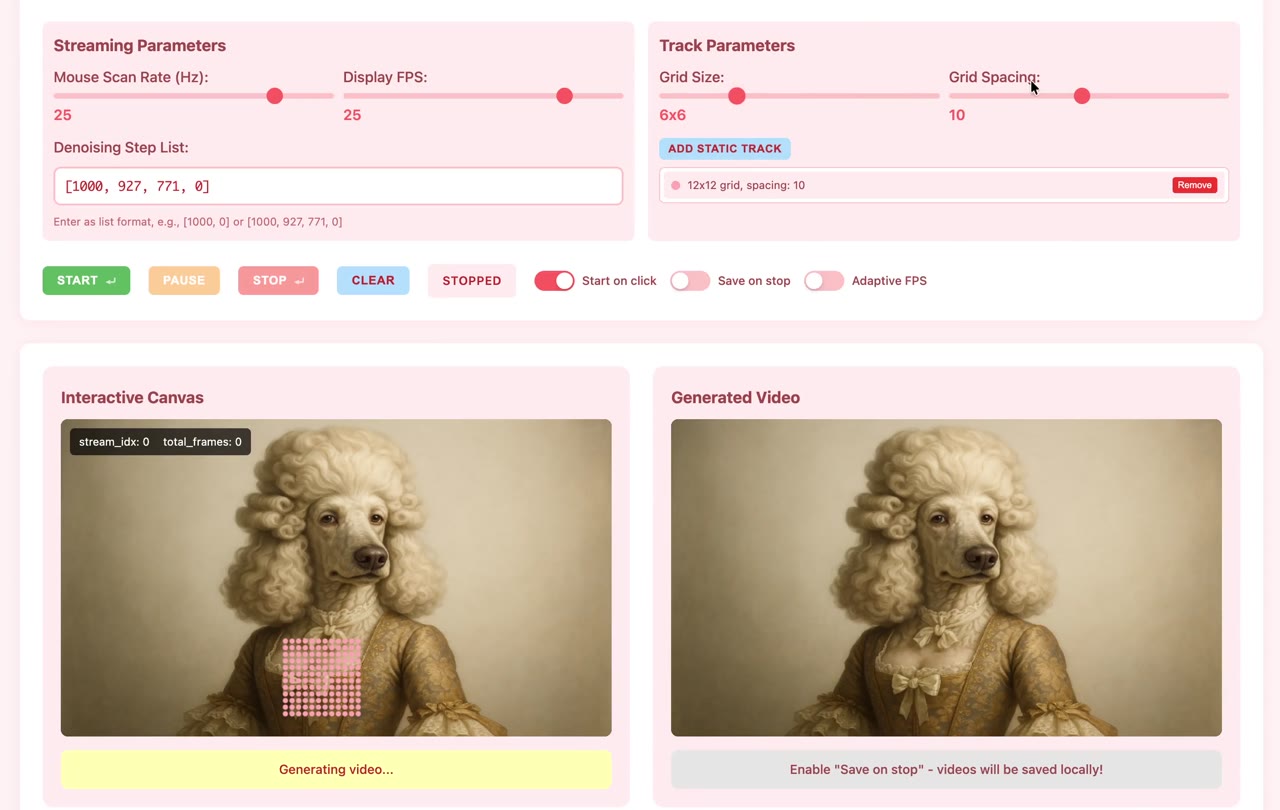
Adobe 参与的 MotionStream 项目,解决了 AI 视频生成慢、且不能中途修改的问题。你现在可以像“实时导演”一样,边生成边调整。 1️⃣ 核心原理:它用了“老师傅带徒弟”的办法。先训练一个很强但很慢的“老师模型”,再让它把“直觉”教给一个轻量级的“学生模型”。这个学生模型虽然没看完全部剧本,但反应奇快,能做到实时推理。 2️⃣ 实际效果:在 H100 显卡上,720p 视频能跑到 23.9 帧/秒,延迟很低,肉眼几乎无感。 3️⃣ 怎么交互:你可以实时在屏幕上画线来控制运动路径,或者直接用鼠标拖动画面里的物体,镜头也会跟着动。 GitHub:https://github.com/alex4727/motionstream #AI视频 #MotionStream #AdobeResearch #AIGC #实时生成
Gemini 3 Pro 预览版现身:100万 Token 上下文窗口
谷歌下一代模型 Gemini 3 Pro 预览版已在 Vertex AI 平台出现,传闻支持 100 万 Token 上下文。 1️⃣ 核心看点:100 万 Token 上下文窗口。 这个容量远超 Claude 3 (20万) 与 GPT-4T (12.8万),意味着能一次性分析整本书或大型代码库。 2️⃣ 其他能力:多模态处理增强,覆盖实时视频理解、3D 识别;内置“深度思考”模式,提升复杂推理。 3️⃣ 推出路径:目前在 Vertex AI(标签 gemini-3-pro-preview-11-2025)向企业客户预览,预计 12 月向开发者(AI Studio)开放。 企业用户可通过 Vertex AI 申请测试;开发者可留意 Google AI Studio 的后续更新。 #Gemini3Pro #GoogleAI #LLM #大模型 #VertexAI

美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
