Kimi 网页端可以选择 K3 模型了

更多动态
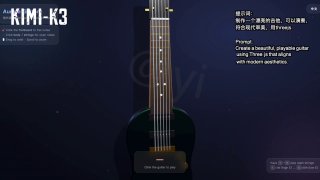
2.8 万亿参数,896 个 MoE 专家,每次只激活 16 个,原生 1M 上下文 + 多模态。 AA 智能指数 57,压过 Opus 4.8 和 GPT-5.5,只输给了 Fable 5 和 GPT-5.6 Sol。Arena WebDev 榜已经登顶,长程 Agent 任务 1527 分排第二。 价格也是真的贵,输入最低 ¥2/百万 token(缓存命中 90%+),输出 ¥100。 7 月 27 日前会开源,是目前最强开源模型。 我用 Kimi-K3 生成可演奏的吉他,最终效果很惊艳。 API 调用一共花费了 ¥5 ,期间经常遇到 429 错误。综合来看 K3 目前的价格确实过高,而且算力也很紧张。
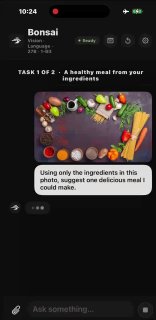
Bonsai 27B,第一个能在手机上跑的 27B 多模态模型。 基于 Qwen3.6 27B,端到端极低量化。 Ternary 版 5.9GB,benchmark 平均 80.49 分,保留 95% 全精度。 1-bit 版 3.9GB,平均 76.11 分,保留 90% 精度,数学 benchmark 93.40 分,距 FP16 仅差 2 分。 iPhone 17 Pro 实测 11 tokens/s,262K 上下文。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。
