告别服务器运维,我这周用 EdgeOne Pages 跑通了出海 AI
更多动态
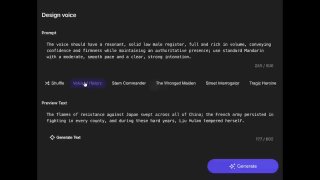
Qwen 刚发布的这俩新模型
,可能要省掉我每个月给 ElevenLabs 交的订阅费了。 主打「3 秒克隆」和「文本捏人声」,对于我们这种要做多语言视频的创作者来说,吸引力很大。 具体有两个新成员: 1️⃣ VoiceDesign (VD-Flash):不用找现成音色,直接用 Prompt「捏」声音。 假如我想给独立开发的小游戏 NPC 配个“焦虑的中年侦探”音色,以前得在素材库翻半天,现在写几行指令就能生成。官方测试说在角色扮演场景下比 Gemini-2.5-pro 还稳。 2️⃣ VoiceClone (VC-Flash):只需 3 秒干音就能克隆。 这对出海做内容太友好了,支持中英日等 10 种语言。我试着把我的中文克隆成西班牙语,语调的上下文断句比 Grok 要自然,没有那种明显的“机械感”。 虽然官方数据说错误率低了 15%,但我实测感觉在极快语速下还是偶尔会吞字,不过作为生产力工具完全够用了。 #AI语音 #独立开发 #Qwen #开源模型 #效率工具

蚂蚁刚开源的 AntAngelMed
,可能是目前普通开发者能本地部署的最强「AI 医生」。 这两周都在研究这个刚发布的 100B 模型,几个实测感受分享给想做垂直赛道的兄弟: 1️⃣ 架构聪明不吃灰:虽然是千亿参数,但用了 MoE(混合专家)架构。好比医院挂号,只唤醒对应科室的专家干活,而不是让全院医生一起上。在我这边的推理测试里,计算效率比传统稠密模型高不少。 2️⃣ 术业有专攻:官方数据在 HealthBench 拿了第一。我试着投喂了几份脱敏病历,对比 GPT-5,它在「解读医学黑话」和「诊疗逻辑」上确实更克制、更严谨,少了很多通用模型那种一本正经的胡说八道。 3️⃣ 隐私党福音:权重和代码都在 HuggingFace 上开源了。对于不想把敏感医疗数据传给公有云的独立开发者,这大概是目前国产化替代的最优解之一。 如果你在关注 AI 垂直落地,或者单纯想给家里存个「数字家庭医生」,这个开源模型值得一试。 #AntAngelMed #AI医疗 #开源模型 #独立开发 #效率工具

美团 LongCat-2.5发布了。
1.6T 总参、激活约 48B,原生多模态,主推长程智能体,全程国产算力训练。 图像量化成多级离散 token,Visual Coding 与 3D 受益。 大规模长程 RL,把失败轨迹转成可验证训练任务。 W4A4 推理,prefill 吞吐提升 43%。 官方自测介于 Claude-Opus-4.8 与 Opus-5 之间。

商汤开源 SenseNova Loop-9B-Preview。
它不堆参数,堆"层数"。32 层解码器,中间 4–27 层同权重跑两遍 → 前向 56 层计算,只存 9B。 自测 BIRD-Dev 71.38、AutomationBench 13.72,超 Qwen3.5-27B;Terminal Bench依旧落后。